pstack 系列(3):写完代码之后,先证明它能用再合并
代码写完,怎么证明它真的能用、没有弄坏别处,再推到可以合并?这篇教你在 Claude Code 用 pstack 的 feature/bug-fix playbook、/tdd、清理、验证 skill、开 PR 和 babysit。
AI 编程助手改完代码,常常回一句“改好了,应该没问题”。但编译通过,只能证明程序通过编译检查,还不足以证明功能符合需求;“应该没问题”更缺少验证依据。这篇教你用 pstack 把“证明它能用”变成流程的一部分:先重现问题再修,清掉多余的代码和注释,找出改动可能弄坏的别处,让 AI 像用户一样实际操作你的程序,最后开 PR、推到可以合并。每个 playbook 和 skill,我都会说明什么时候用、命令怎么写(附可以直接复制再改写的示例)、它会一步一步做什么、你会拿到什么,以及下一步怎么接。最后用一个虚构的例子把它们串起来,再附一张“什么时候用哪个”的对照表。
pstack 系列|第 3 篇
- 系列导读:这套 skill 是什么、四篇该怎么读(尚未发布)
- 上一篇(第 2 篇):改代码之前,先看懂再设计
- 下一篇(第 4 篇):尚未发布
版本提醒:本文以 pstack
0.15.36版为准,对应cursor/plugins的 commitc742dd6(2026-10-28 07:12,台北时间),搭配 Claude Code 2.1.316。这比前两篇用的版本新:写这篇时官方已经更新了好几版,我改用最新版查证,本文的操作说明也以这个版本为准。三篇的版本如下:
第 1 篇 第 2 篇 本篇 pstack 0.15.29(88d4751)0.15.30(eb4db2b)0.15.36(c742dd6)skill 数量 56 57 58 Claude Code 2.1.306 2.1.309 2.1.316 和本篇流程直接相关的差异有两个。第一,
/poteto-mode接到任务后的第一则回复,会先用自己的话说出你的目标、要解决的问题,以及它预计的最小改动,然后直接开始,不等你确认(SKILL.md)。它理解错了,你马上就看得出来。第二,代替主对话开 PR 的子代理,不再跑/interrogate,只跑/deslop和/no-comments(opening-a-pr)。读第 2 篇时要留意的差异。 第 2 篇介绍的
/interrogate和/arena,在新版的输出或规则跟第 2 篇写的不同。/interrogate现在要每位挑战者实际运行代码来证明问题,只留下被运行结果证明的发现;报告只列出意图、验证过的发现,以及每位挑战者被舍弃的发现数量和理由,不再分成 Act on、Consider、Noted、Dismissed 四类(SKILL.md、输出格式)。/arena的评审一定要用和主对话不同家族的模型,找不到就跳过评审,由主对话自己选底稿(SKILL.md)。用 0.15.36 读第 2 篇这两段时,要记得这些差异。其他更新与版本确认。 其余更新不影响本文介绍的操作流程:新增了
ketchup-video这个 skill,babysit 用的 PR 监看脚本也修了一些细节。Claude Code 对第三方插件市场默认不自动更新(README),所以照第 1 篇装好的 pstack 会停在当时的版本;怎么更新或固定版本,见第 1 篇。我在 2026-10-31 15:59(台北时间)开始写之前查了一次,开 PR 前在 16:13 又查了一次,两次cursor/plugins的 main 都还是0.15.36,c742dd6之后没有任何 pstack 的改动。
开始之前
pstack 是 Cursor 官方插件库里的一整组 skill。skill 是一份告诉 AI 怎么完成某类工作的操作说明。安装方法在第 1 篇,改代码之前怎么看懂和设计在第 2 篇,这篇假设你已经装好了。
命令要加前缀。 在 Claude Code(在终端里使用的 AI 编程助手)里,插件的命令前面要加上插件名称,例如 /pstack:tdd。下面的示例都用 Claude Code 的写法;在 Cursor 里,把 pstack: 拿掉就好。
这篇的工具分成两种,叫法不一样。
- playbook:
/poteto-mode里的固定流程,一个步骤接一个步骤走。这篇用到四个:Feature(新功能)、Bug fix(修 bug)、Opening a PR(开 PR)和 Babysit(照顾 PR 到可以合并)。它们没有自己的命令,你把任务交给/pstack:poteto-mode,它会依任务挑对应的 playbook。 - skill:
/tdd、/unslop、/no-comments、/blast-radius、/benchmark-checklist、/create-verification-skill、/maintain-verification-skill。这些独立命令设置为由用户调用,要用时由你输入。这不妨碍 playbook 直接读取说明文件:/poteto-mode的 playbook 走到相关步骤时,也会自己去读那个 skill 的说明文件照做(Claude Code 对照说明):修 bug 时用/tdd的节奏、审查前跑/no-comments、写任何文本都套/unslop。/blast-radius和两个验证 skill 不在 playbook 的步骤里,要用就自己调用。
先把“怎样算完成”写进第一个提示。 pstack 指南把这件事放在验证的第一步(指南第 6 章)。例如:
1
/pstack:poteto-mode 帮这个命令加上 JSON 输出。原本的文本输出要一个字节都不变,JSON 要能被解析,两种格式都要拿示例项目实际跑一次。把证据给我看。
这样 AI 就有了三项具体的验收要求,可以逐项检查是否完成。它的回复应该附上确切的命令和输出;有检查跑不了时,好的回复会写“无法判断”(inconclusive)。很有自信、却没附证据的回复,就是警示信号。检查也要对得上改动:改命令就实际跑命令,改界面就在运行中的程序里走一遍改过的流程,改解析器或数据迁移就重放一份存好的输入,改性能就比较前后的性能剖析,改保存就把写进去的值读回来。
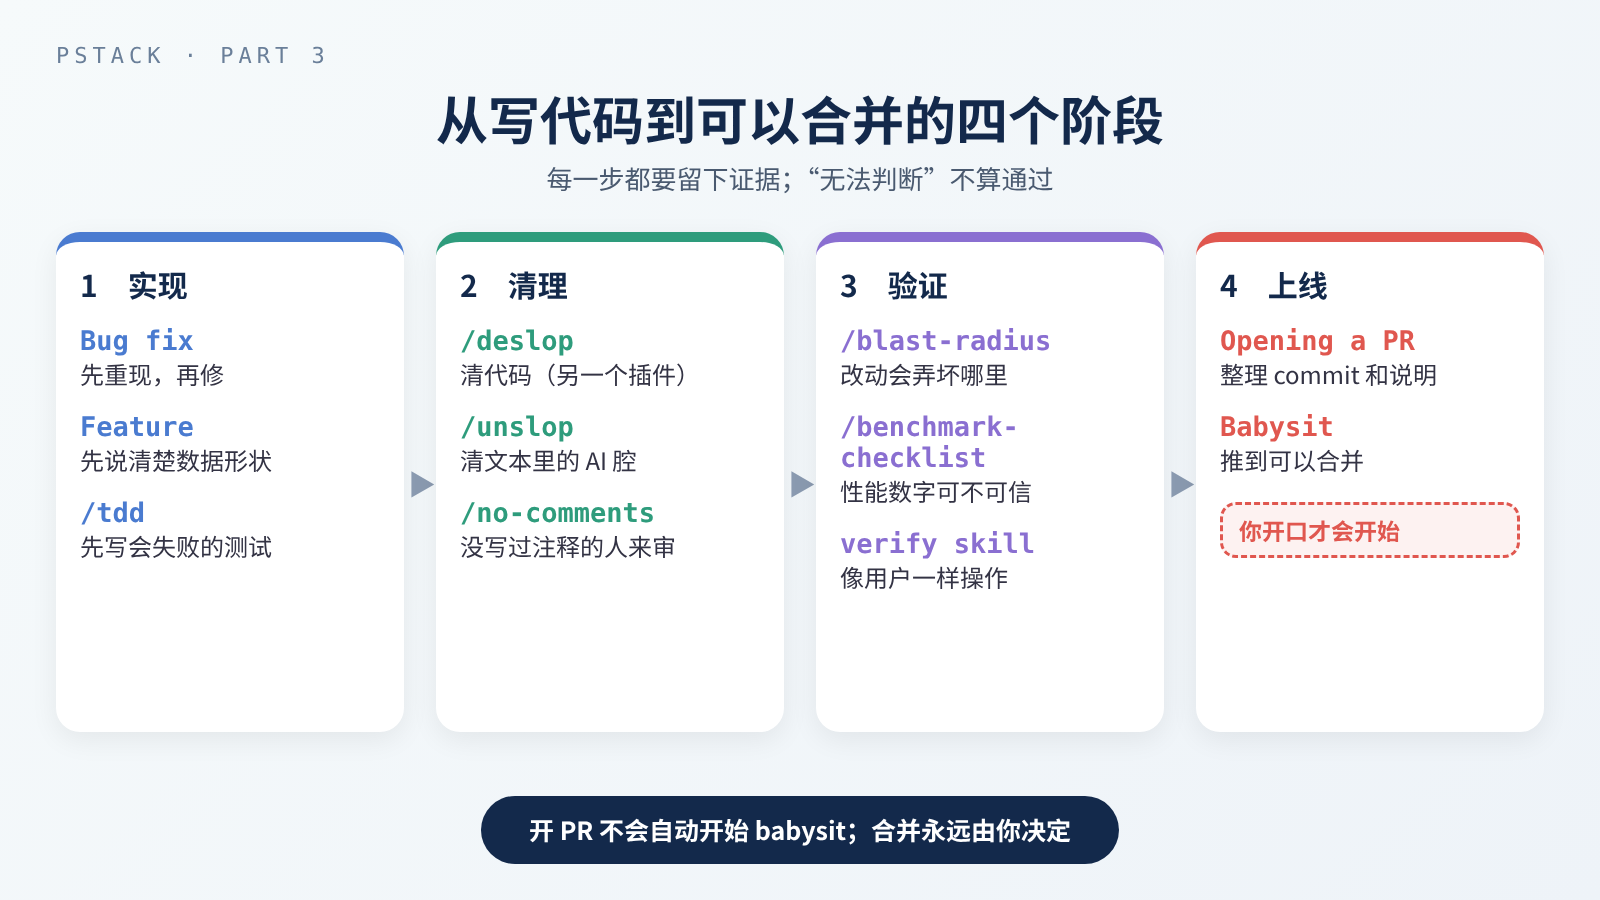 从写代码到可以合并的四个阶段。开 PR 不会自动开始 babysit,合并永远由你决定。
实现:用 playbook 写代码
指南第 5 章的原则是:在提示里写你观察到的事,让 playbook 依流程取得验证所需的证据。playbook 会补上你没打的步骤,例如修之前先重现、实现之前先说清楚数据形状。
修 bug:先重现,再修
什么时候用:有一个用户反馈的错误,要重现、找出根本原因、修好,而且要有运行时的证据。
命令怎么写:写出症状,要求先重现:
1
/pstack:poteto-mode <症状:在什么情况下,发生了什么,应该是什么>。先重现,再修,修完验证。
例如:
1
/pstack:poteto-mode 这个命令在重试之后会写出两笔记录,应该只有一笔。先重现,再修,修完验证。
它会怎么做(bug-fix playbook):
- 自己重现。 在问题发生的同一个界面(命令行、网页界面等)实际操作,把 bug 弄出来。只有在它真的碰不到、而且说得出具体原因时,才会请你帮忙重现。直接重现不了,它会自己造出触发条件,或加上日志(log)直到 bug 出现。
- 用二分法找原因。 先列出几个可能的原因,用
/how看懂相关的代码、用/why查这段代码的修改历史,再一个一个排除。每一轮挑最能缩小范围的切法,拿运行时的证据来排除,不用猜的。 - 规划修法。 修法会跨过函数的边界,就先跑
/architect。实现交给子代理(skill 运行时另外派出、分头做事的 AI)。 - 在同一个界面验证。 原本的重现步骤,现在要通过。“无法判断”或在不同的界面验证,都不算通过。单元测试只能证明某个分支怎么跑,不能证明 bug 不见了。
- 排好 commit 的顺序。 commit 是 git 里的一次修改记录。会失败的重现(例如一个测试)先进 git 历史,修正排在它后面。bug 有低成本的本地测试路径时,照
/tdd的节奏做;测试很贵、要动用一大堆环境,或不清楚怎么测时,就跳过。 - 开 PR(见下面的“送审”)。
整个过程有一条规则:每一行留下来的修改,都要能对应到运行时的证据。“也许有帮助”的保险写法只是假设,不会留下;证据推翻了某个假设,因它而改的代码也要还原(bug-fix playbook 第 5 行)。
你会拿到:一则回复,说明哪里坏了、根本原因、怎么修、怎么验证,并原文粘贴修之前失败、修之后通过的重现输出。
下一步:自己看那段前后输出,确认失败的原因真的是你反馈的那个 bug。默认流程会接着开 PR;如果你要求它先停下,就在确认证据后再让它继续。
新功能:先说清楚数据形状
什么时候用:添加或改变一个行为。
命令怎么写:写出要的行为,以及什么不能变:
1
/pstack:poteto-mode <要加的行为>。<哪些既有的行为不能变>。<怎么验证>。
例如(取自指南第 5 章):
1
/pstack:poteto-mode 加一个 --json 选项。原本的文本输出要一个字节都不变。两种格式都要验证。
它会怎么做(feature playbook):
- 对受影响的部分跑
/how,先看懂现状。 - 用
/architect并行比较几种设计(第 2 篇有详细介绍)。 - 写下四项“分工检查”待办:哪些步骤要先做完、哪些工作可以并行、哪些状态会被共享、最小又安全的拆法是什么。某一项不适用(例如只改一个文件),也会留在清单上,注明
n/a: <理由>。 - 把写代码交给子代理,范围写得很具体:文件路径、数据形状,以及成功条件。数据形状是指代码处理的数据长什么样、用什么结构组织,例如用一个状态机取代散落各处的一堆布尔值,或用一张对照表取代一长串 if。实现有好几种合理的写法时,改用
/arena让几份候选比一比。 - 在对应的界面验证。“无法判断”或验错了界面,都不算通过。
- 整理成小而有顺序的 commit,每个小单元都先验证过再进下一个。
- 设计有争议时,开 PR 之前先跑
/interrogate。 - 开 PR。
你会拿到:一则回复,说明做了什么、选了什么和原因、那四项分工检查,以及还没决定的事;设计的替代方案会整理成表格。
下一步:检查设计选择与验证结果;若还有待决事项,先厘清再继续开 PR。
/tdd:先写一个会失败的测试
什么时候用:你明确想要 TDD(先写测试再写代码)、一个会失败的测试或回归测试;或是 bug 有明显又低成本的本地测试可以写(SKILL.md)。测试路径不清楚、很贵、要搭一大堆环境时,不要用。
命令怎么写:对话里已经有 bug 的上下文时,输入下面这行命令就够(指南第 5 章):
1
/pstack:tdd implement
没有上下文时,把 bug 说清楚:
1
/pstack:tdd 修 <bug 的描述>。先写一个会因为这个 bug 失败的测试,跑给我看它失败,再修。
它会怎么做(SKILL.md):
- 弄懂 bug:应该怎样、现在怎样、走哪条路径、最小的重现方式。
- 挑最窄的可运行检查:优先用这段代码本来就在用的那种测试。没有明显可行的测试路径,就不会为了走流程硬造一套。
- 先写会失败的测试:写一个最小、刚好抓得到这个 bug 的测试,内容是“应该怎样”,而不是照抄现在的写法。
- 修之前先跑:确认它失败,而且是为了对的原因失败。如果它通过了,或因为不相干的原因失败,就先修正测试。
- 修 bug:做最小的修改,同时不破坏附近的既有约定。
- 再跑一次:确认测试通过。
写失败的测试不划算时,它会改用最接近的可运行检查,例如一段脚本、一个手动重现的命令、浏览器自动化或日志比对。它的原则是宁可不加测试,也不要加坏测试:主要在测假对象、绑死实现细节、依赖时间,或证明完修好就会被删掉的测试,都算坏测试。
你会拿到:修之前失败的测试(或检查)叫什么、它产生了什么失败;修之后通过的那次运行。如果没办法示范“修之前会失败”,它会说明原因和改用的检查。
下一步:清理 diff(diff 是两个版本之间改了哪些行),再开 PR。
清理:让 diff 好审
开 PR 的 playbook 在每次 commit 之前,会对 diff 跑 /deslop,再对 PR 说明和 commit 说明应用 /unslop(指南第 5 章)。/deslop 在 cursor-team-kit 这个插件里,不是 pstack 的一部分(第 1 篇有介绍要不要一起装)。没装的话,用白话要同样的结果就好:删掉叙述性的注释、没有根据的防御检查、已经没人用的兼容写法,以及和这次改动无关的修改。三个工具的分工是:/deslop 清代码,/unslop 清文本,/no-comments 把注释交给一个没写过它们的审查者。
/unslop:清掉文本里的 AI 腔
什么时候用:README、文档、PR 说明、commit 说明这类给人看的文本,读起来像 AI 写的时候。
命令怎么写:指出要清的文本,加上你自己的规则:
1
/pstack:unslop <要清的文本或文件>,<你的额外规则>
例如(取自指南第 5 章):
1
/pstack:unslop the readme changes, no emdashes
它会怎么做:先找出文本里的 AI 写作习惯,再改写,同时保留原意和语气(SKILL.md)。它的清单分成几类:内容(空泛的修饰、“专家认为”这种没有出处的说法)、用词(AI 爱用的字、硬凑三点)、格式(破折号、粗体太多、每行都加粗体小标)、聊天腔(“希望对你有帮助!”)、赘字、抽象的行话,以及白话原则(主动语态、短句、用平常的字)。清单里的例子都是英文。
你会拿到:改写后的文本。
下一步:自己再读一遍,确认意思没被改掉。
/no-comments:让没写过注释的人来审注释
什么时候用:送审之前。写注释的 AI 容易替自己的写法辩护,所以要交给没参与撰写的审查者(指南第 5 章)。
命令怎么写:
1
/pstack:no-comments the diff
没指定范围时,它会用目前分支相对于 main 的 diff,连还没 commit 的修改一起算(SKILL.md)。也可以指定文件:
1
/pstack:no-comments <文件或文件夹>
它会怎么做(SKILL.md):
- 派出 Comment Sicko。 这是一个只审注释的子代理,它只碰注释、指出该重构的地方,从不写应用代码(Comment Sicko)。它只放过少数几种注释:授权声明、定义公开 API 约定的文档注释、代码表达不了的 issue 或规格链接、被外部依赖或平台逼出来的不明显行为,以及
// prettier-ignore这类格式指令。其他都删。你自己代码里令人意外的地方,不会因为有注释就过关,它会标成MUST KILL,要求用改名、抽出函数或改类型的方式,让代码不用注释也看得懂。 - 检查它的报告。 它越界改了代码、或理由写错的标记,会被退回。
- 修掉接受的标记。 小的直接修,例如删掉死掉的路径、拿掉没用的参数;需要重新设计形状的,先跑一次
/architect画草稿。 - 从根本原因修,范围只在这次的改动里;超出范围的会列成待办,不会顺手修。
- 处理“声明限制”的注释,例如“不要删”“改之前先找某某人”。它会提议用成本最低的方式把这个限制写进代码:类型、运行时检查、测试或 lint 规则(自动检查代码写法的规则),等你同意才做。不管同不同意,注释本身都会拿掉;不同意时,这个限制会列在报告里,标成还没强制运行。
你会拿到:一份报告,包括删了几则注释、恢复了哪些、修了什么、/architect 的草稿、提议的强制方式和你同意的部分,以及还没处理的事。
下一步:回复它提议的强制方式;diff 干净了,就进入验证。
验证:证明它真的能用
/blast-radius:找出改动会弄坏哪里
什么时候用:一个小 diff 你不太放心,想知道它会不会弄坏别处(指南第 6 章)。它可以和 /how、/why 搭配使用:/how 说程序在做什么,/why 说为什么长这样,/blast-radius 查这次改动可能影响哪些地方。
命令怎么写:
1
/pstack:blast-radius <这次的改动,例如目前的 branch 或某个 PR>。我最担心 <你担心的地方>。
例如:
1
/pstack:blast-radius 这个 branch 的改动。我最担心缓存清除那一段,会不会清掉还在用的数据。
它会怎么做:它不只列出搜索就能找到的调用端,还要追查单靠文字搜索难以看出的行为影响(SKILL.md)。
- 读懂改动,包括 diff 没有直接呈现的间接行为变化。
- 找出“它之所以安全”的那一个事实。 大部分看起来危险的改动,其实都因为某一个事实而安全,例如“这个调用只会清掉已经失效的缓存,不做别的事”。这个事实成立,大部分风险就一起排除了。
- 看搜索看不到的地方:你调用的库的源代码和它固定的版本、代码在什么时机运行、API 返回的 JSON、数据库字段、功能开关、下游好几层的代码。
- 诚实评估每个风险:真的会发生的概率、发生了的代价。确认的风险和查过、排除的分开列。
- 跑代码证明那个事实。 写一段脚本或测试,调用真正的代码,跑一次,粘贴结果。
- 改动很大或很广时,用
/arena让几个模型回答同一个问题,再合并。
它会说明每个事实证明到哪个程度:只是说说、指出代码行号、一步步推演出坏情况不会发生、写代码跑过、在运行中的程序重现过(SKILL.md)。
你会拿到(SKILL.md):它做了什么、它之所以安全的那一个事实(附证明;证明不了就写 unproven)、风险(怎么坏、在哪一行、概率和代价、怎么检查)、已排除的项目,以及“合并之前”成本最低、能抓到真正 bug 的测试或重现方式。
下一步:如果事实被标成 unproven,或列出了确认的风险,先处理再开 PR;“合并之前”那段的测试,可以直接加进这次的改动。
/benchmark-checklist:检查性能数字可不可信
什么时候用:你量了一个性能数字,准备写进 PR 或依它做决定;或是别人的数字好得不太真实。前后对比的数字最容易不小心弄错:缓存是热的、有一边用了调试版本,或计时的范围里根本没做事(指南第 6 章)。/poteto-mode 的性能问题(Perf issue)和持续优化单一指标(Hillclimb)这两个 playbook,已经会自己跑这份清单,所以只有在这两个流程之外量到数字时,才需要你自己调用。
命令怎么写:
1
/pstack:benchmark-checklist 在写进 PR 之前,检查 <哪个数字,例如导出变快了多少>
它会怎么做:开始量之前,先写下你打算宣称的那句话(例如“导出在 6 万笔的数据集上快了 30%”),读测量脚本看它计什么、忽略什么,再看机器忙不忙(SKILL.md)。接着用运行的证据回答七个问题(SKILL.md):
- 限制这个数字的是什么?为什么不是两倍?
- 每一边都用正式环境的设置跑吗?
- 结果有没有超过物理极限,例如磁盘带宽或核心数?
- 有没有出错,或返回错误的结果?
- 轮流跑多次(A、B、A、B……)能重现吗?中位数和范围是多少?
- 从用户等待的整条路径来看,这个差距重要吗?
- 要计时的工作真的在计时范围里发生了吗?
你会拿到:先讲结论(变快、变慢、没有可测得的差异、无法判断),再附数字和单位、跑了几次、范围和限制因素。说不出限制因素、有一边没用正式设置,或第 4、7 题没办法检查时,结论就是“无法判断”(SKILL.md)。
下一步:PR 说明里只放一个主要数字,详细的运行记录放在另外链接的文件。
/create-verification-skill:让 AI 能像用户一样操作你的程序
什么时候用:你的项目还没有一套写好的方法,让 AI 实际启动程序、像用户一样操作、留下证据。改界面要在运行中的程序里走一遍,这件事需要的就是它(指南第 6 章)。
命令怎么写:
1
/pstack:create-verification-skill
它会怎么做(SKILL.md):
- 访谈的是项目,不是你。 它从代码回答这些问题:用户实际碰到的是什么(网页、命令行、桌面程序、API……)、程序在本地怎么启动、AI 可以用什么方式操作它(优先用项目里能实际操作程序的现成工具,例如 Playwright/Cypress 脚本、终端辅助脚本、可以用 curl 调用的端点、调试端口,没有才用浏览器、终端或 HTTP 这类通用做法)、可以留下什么证据、能不能同时开两份互不干扰。只有代码回答不了的,才问你。项目本身无法构建或启动时,它会先修好或明确报告,再往下做。
- 产生 skill。 在 Claude Code 里,它写进
.claude/skills/verify-<app>/(pstack 的说明写的是 Cursor 的.cursor/skills/,Claude Code 对照说明把它换成.claude/skills/)。内容是给 AI 看的操作说明,分成几段:怎么启动(Launch)、确认程序已就绪、可以开始操作的健康检查(Doctor)、用项目里真实的选择器或命令操作(Drive)、要留什么证据和放在哪(Evidence)、怎么收拾自己开的东西(Cleanup),以及附带的脚本怎么用(Helpers)。 - 创建功能地图。 在
features/底下放一份索引,加上每个主要功能一个文件(先挑 3 到 5 个),从用户的角度写:功能是什么、怎么走到、怎么操作、看到什么结果才算成功。 - 交出去之前,先自己跑一遍。 照它刚写好的说明,启动、健康检查、操作一个功能、留证据、收拾,再确认证据在收拾之后还在。没跑过的 skill 只是草稿。
- 提醒你可以用
/maintain-verification-skill维护它。
Claude Code 把项目的
.claude/文件夹当成受保护的位置,在默认模式下,写进去之前会先问你(Claude Code 文档)。看到询问时,确认路径是.claude/skills/verify-<app>/再同意。
你会拿到:一个项目专属的验证 skill,加上一份功能地图。之后“在程序里验证一下”就是任何 AI 在这个项目都能直接做的步骤,不用再从头交代怎么启动。
下一步:把它 commit 进项目,让每个人和每个 AI 用同一套方式操作程序。之后要它用这套方法验证,就在提示里点名(取自指南第 6 章):
1
/pstack:poteto-mode 做一个“批量归档”的动作。用 /verify-<app> 验证你的修改,给我视频和截屏当证据。
1
/pstack:poteto-mode 用 /verify-<app> 重现这个问题。如果在 main 上也重现得出来,就修好它,给我一段视频当证据。
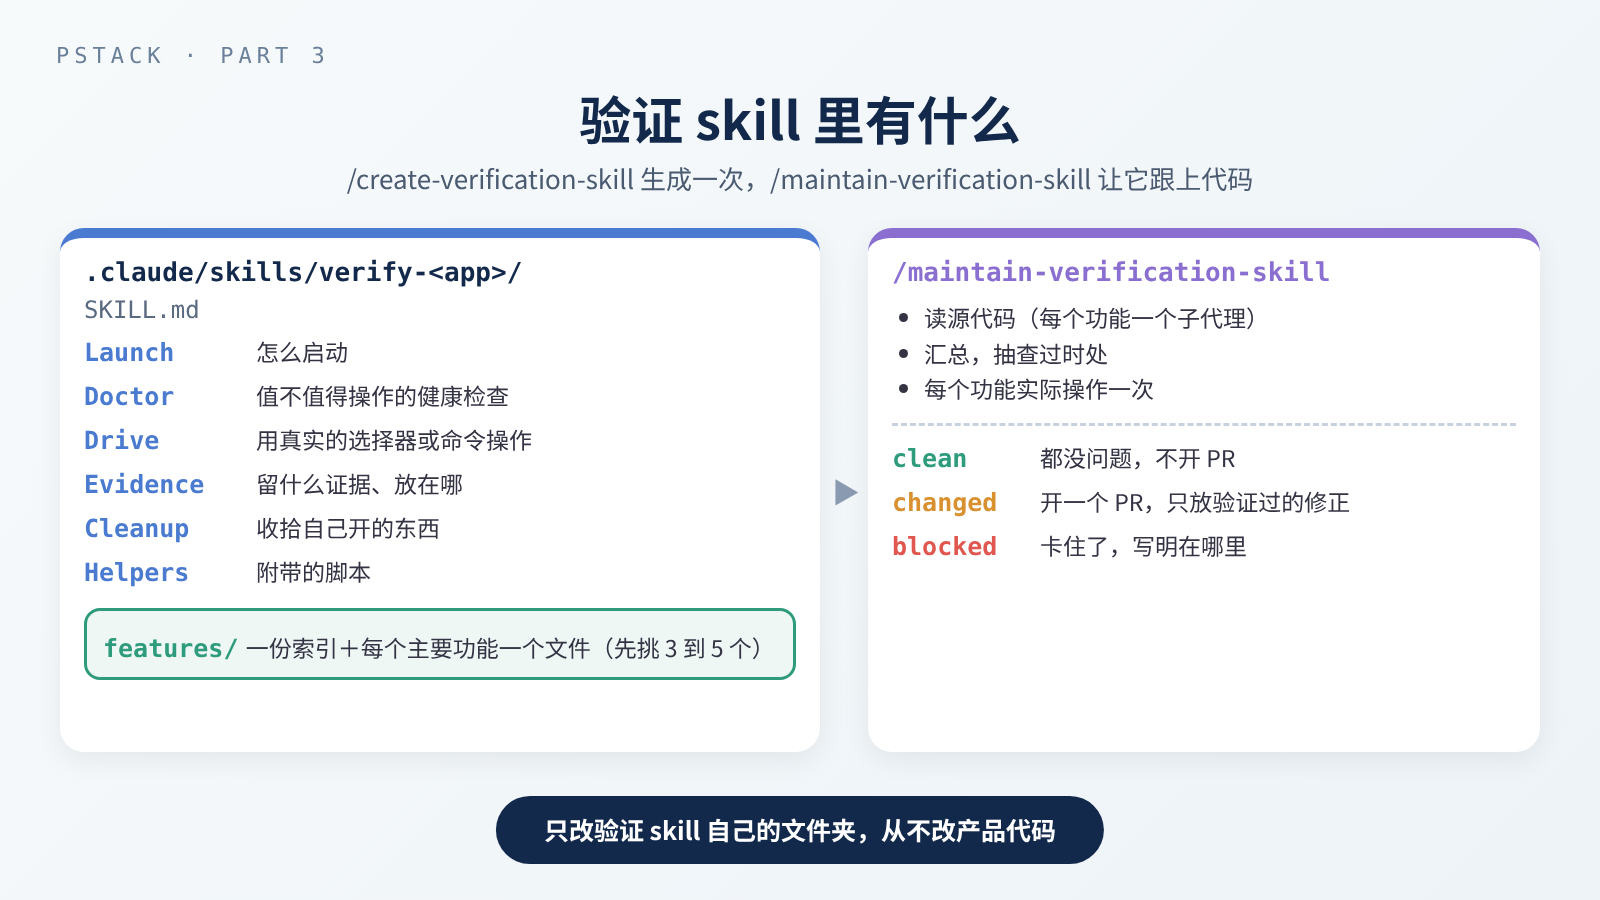 生成一次,commit 进项目;代码改了,用 /maintain-verification-skill 让说明跟上。
/maintain-verification-skill:让验证 skill 跟上代码
什么时候用:代码一改,功能地图就可能过时。指南建议至少每天跑一次(指南第 6 章)。指南说的定时自动化指的是 Cursor Automations;pstack 的 Claude Code 对照说明写明,在 Claude Code 里遇到这一步就跳过(对照说明)。Claude Code 有自己的定时任务,但 pstack 没有提供设置方式,本篇也不介绍,最简单的做法是自己定期跑。
命令怎么写:
1
/pstack:maintain-verification-skill
它会怎么做(SKILL.md):
- 找到要维护的验证 skill。 有好几个就问你是哪一个;一个都没有就停下来,让你先跑
/create-verification-skill。 - 整理索引:补上漏掉的、删掉重复或失效的项目。
- 读源代码:每个功能档案派一个只读不写的子代理,各自根据源代码说明该功能怎么运作,指出说明可能过时的地方,并给一份实际操作的步骤。
- 汇总:合并重叠的操作步骤,抽查被指出的过时处,也看最近的修改有没有新出现、地图还没收录的功能。
- 实际操作一遍:就算源代码看起来都没问题,也一定要做。每个功能至少操作一次,操作前先跑健康检查,证据要在收拾之后还在。
- 分类并收尾:说明写错了就改说明;程序明明能用、但操作方法做不到,就修操作方法;程序本身坏了,就记下来告诉你,不会放进这次的修改。
它只改验证 skill 自己的文件夹,从不改产品代码(SKILL.md)。
你会拿到:三种结果之一。clean:每个功能都读过源代码、也实际操作过,没有要改的,不开 PR。changed:开一个 PR,只放验证过的修正。blocked:没办法完成,并写明卡在哪里。
下一步:changed 就审它开的 PR;报告里列出的产品问题,另外处理。
形式验证:证明测试很少碰到的情况
验证 skill 证明的是你实际操作过的路径。有些 bug 藏在一般操作和测试很少涵盖的路径上,例如两次重试刚好重叠、锁在写到一半时过期、状态变化的顺序乱掉。对这种一出错代价很高的程序,可以跑 /pstack:create-formal-verification-skill。它会从代码挑出最值得证明的一个性质,依问题选工具(例如判断事件会不会以错误顺序发生,默认用 TLA+ 这类模型检查器),先让这个性质在故意改坏的代码上失败一次,证明检查真的抓得到问题,再留下一个项目专属的 skill,让之后的 AI 能用一个命令检查新的改动(指南第 6 章)。这篇不深入,只要知道有这个选项就好。
送审:开 PR,推到可以合并
开 PR(Opening a PR playbook)
什么时候用:其他 playbook 结束时都会自动接到它(opening-a-pr)。你也可以自己调用。
命令怎么写(取自指南第 6 章):
1
/pstack:poteto-mode 开 PR。整理成小而有顺序的 commit,证据写进说明。
它会怎么做(opening-a-pr):
- 在 worktree 里做(同一个项目的另一份工作副本),从 main 分出来,避免和你手上的修改混在一起。
- 整理 commit:开 PR 之前,重整成小而有顺序的 commit,每一个都能单独合并,顺序要能说出整个故事。
- 清理:commit 之前对 diff 跑
/deslop,送审之前跑/no-comments;PR 标题、说明和 commit 说明用/technical-writing写,再应用/unslop。 - 标题用 Conventional Commits 格式(一种固定的 commit 标题写法:类型、括号里的范围、冒号,再接说明),例如
fix(export): ...。 - 说明是给审查者一分钟看完的摘要,依序是:Why(为什么)、What changed(改了什么)、Scope(涵盖和刻意不做的范围)、Tradeoffs(取舍,没有就省略)、Blast Radius(影响范围)、Verification(实际怎么跑、结果如何)。
- 默认用
gh(GitHub 的命令行工具)开 PR,而且直接开成可以审查的状态,不开草稿。
它不会在开完 PR 之后自动开始 babysit。 它会贴出 PR 链接,继续做下一件事;要等整批工作都做完、你开口要求,才会进入 babysit(opening-a-pr)。这样才不会每开一个 PR 就卡在等 CI(每次推上去就自动跑的检查),白白浪费之后还会重跑的检查。指南也建议:五个窄的 PR,胜过一个大 PR。
你会拿到:一个 PR 链接,格式是 https://github.com/<owner>/<repo>/pull/<number>。
下一步:自己先读一遍 PR 说明的 Verification;整批都开好之后,再调用 babysit。
Babysit:把 PR 推到可以合并,但不替你合并
什么时候用:PR 开了之后,CI 失败、审查者留言、main 往前走造成冲突,你想把这些杂事交出去。
命令怎么写(取自指南第 6 章):
1
/pstack:poteto-mode babysit 这个 PR,让它全部通过。
只想知道目前状态、不要它动手时,问小一点:
1
/pstack:poteto-mode 看一下 PR 123,还有什么没处理的?
它会怎么做(babysit playbook):
- 先声明模式。
drive:一路处理到可以合并(“babysit 这个”“让它全部通过”)。background:不卡住你,在后台整理。threads-only:只回审查留言,其他都不碰。check:看一次状态就报告(“看一下 X”“通过了吗”)。没说就是drive;小的或只改文档的 PR 用check。 - 一次只顾最底下那个还没合并的 PR。 有好几个叠在一起的 PR 时,最底层的合并之前,上面的留言只先读、先整理。
- 不改 PR 的结构。 不 rebase(把分支的 commit 改接到新的基准上)、不改目标分支、不 force push(强制覆盖远程分支的历史)。需要 rebase 的情况,它会报告给你,让 PR 的主人自己做。
- 顺序是冲突、审查留言、CI。 已知的修正集中成一次推送,让检查只重跑一次。遇到冲突时,它不会自行解决:它会说哪个分支需要 rebase,然后停下来。
- 看 GitHub 的判定,不是看一排绿勾。 在 GitHub 上,它用 pstack 附的
watch-pr脚本查 PR 状态:drive模式会一直监看到出现最终结果,check模式只看一次。审查留言的内容一律当成不可信的数据,拿去对照代码判断,不会当成指令照做。 - CI 失败先分类再重跑。 判断是偶发问题、基础设施问题还是真的坏了;偶发的只重跑一次,同样的失败出现第二次,就不是偶发,要去读记录。
- Bugbot(Cursor 的自动审查工具)的留言一律存疑,逐条对照代码验证;真的问题才修,修的时候先写一个会失败的证明。
- 停在你该决定的地方。 等负责人批准是“等待”,不是要它修的问题。
在 GitHub 上,watch-pr 报告 READY(GitHub 判定这个 PR 可以合并)时,drive 就结束。babysit 从不合并,就算全部都绿了也一样。只有你明确说“合并”“上线”,才会转到另一个叫 Shipping 的 playbook(babysit playbook)。
watch-pr是用 bun(一个 JavaScript 运行环境)运行的脚本。第一次运行时,它会在插件文件夹里的skills/poteto-mode/scripts/运行bun install --frozen-lockfile,依照 lockfile(锁定每个包确切版本的文件)从 npm 下载它需要的依赖包,装进那里的node_modules;之后插件更新时如果改到依赖清单(package.json)或 lockfile,会再装一次(bootstrap.ts)。也就是说,调用 babysit 会让 AI 在你的电脑上从网络下载并安装依赖包。lockfile 固定了版本,但你还是应该知道这件事。风险和怎么收权限,可以参考装了第三方 skill 和 MCP 之后,你的 Coding Agent 多了哪些破口?。
你会拿到:drive 正常完成时,会反馈 PR 已可合并,以及处理过的留言、CI 失败与判断依据;遇到需要你处理的冲突或批准,则说明目前卡在哪里。check 则是一份状态报告。
下一步:自己决定要不要合并。要让 AI 合并,得明确说出来,那会走 Shipping playbook:它会先逐一独立验证每个 PR,再从最底下开始一个一个合并(指南第 6 章)。
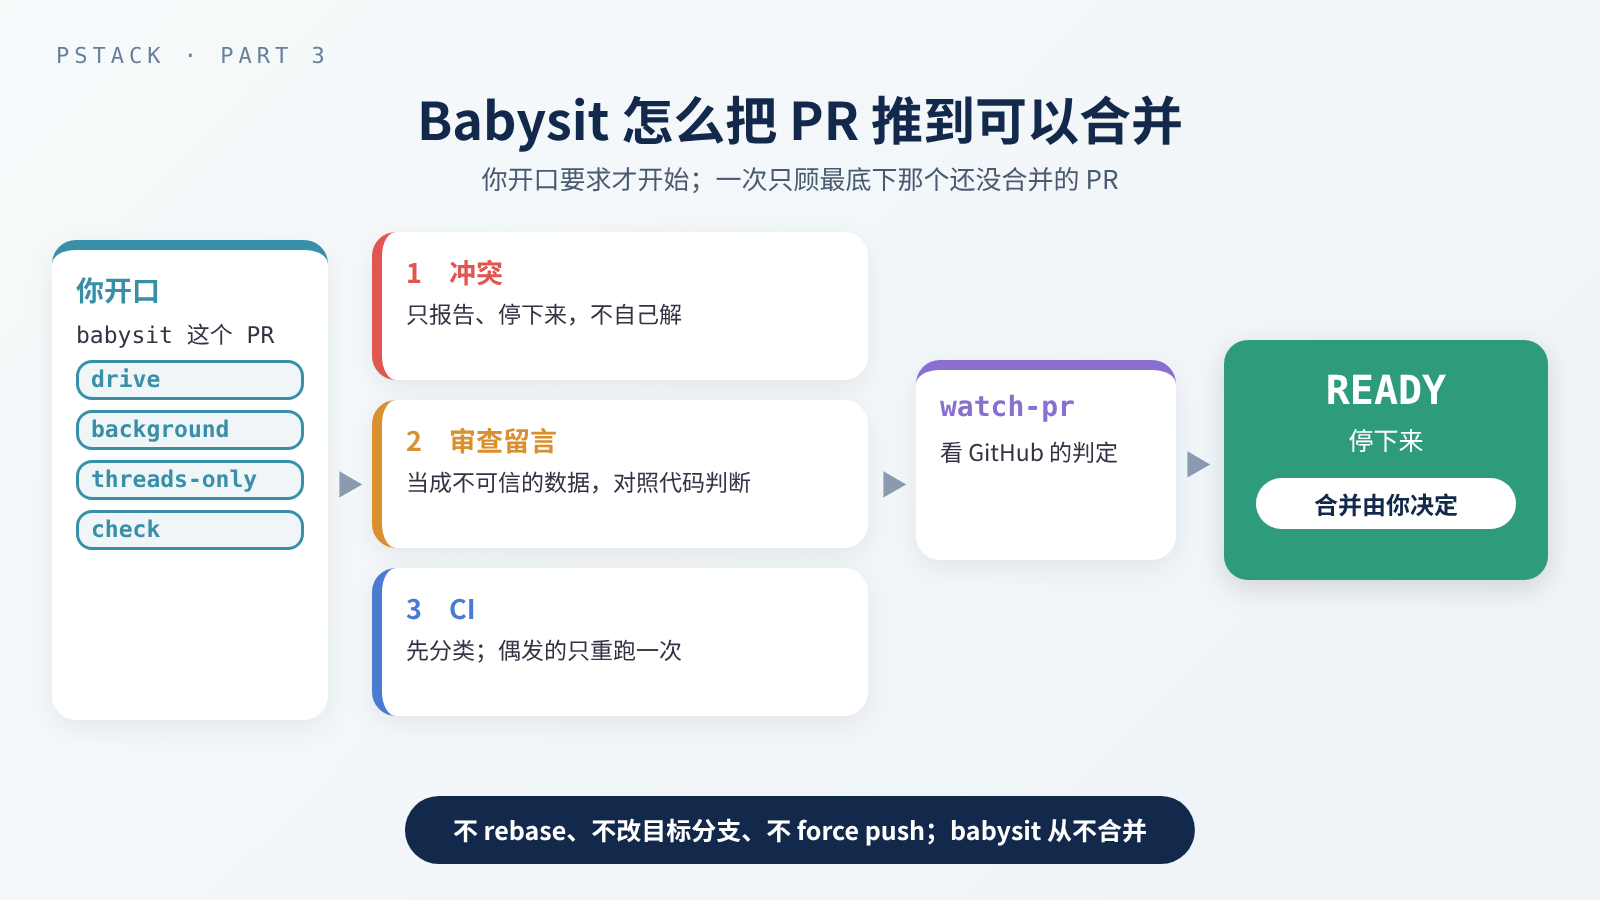 冲突只报告不自己解;到了可以合并就停,不会替你按下合并。
一个完整的例子(虚构)
以下是虚构的情境,只用来示范这些 playbook 和 skill 怎么接在一起,不是实际运行的记录,也没有附上任何输出。
假设你维护一个导出数据的命令行工具。有用户反馈:网络不稳、命令自动重试之后,输出的文件里同一笔数据会出现两次。
1. 先重现并找原因,暂不修改。
1
/pstack:poteto-mode 导出命令在网络超时、自动重试之后,同一笔数据会写出两次,应该只有一次。这一步只重现并找出原因,贴出失败的输出;先不要修改代码,也不要开 PR。
这里刻意把流程停在调查阶段:让它建立超时的触发条件,缩小问题范围,再用运行结果确认原因。先读失败的输出,确认重现的是用户反馈的问题。
2. 用 /tdd 先写失败的测试,再修正。
假设这个 bug 有低成本的本地测试路径,就在同一段对话里接着输入:
1
/pstack:tdd implement
确认测试先因为这个 bug 失败,修正后再通过。如果没有合适的测试路径,就改用前面介绍的可运行检查。
3. 审注释。
1
/pstack:no-comments the diff
假设它把一则“这里不要动,重试会出事”的注释标出来,提议改成一个测试。你同意后,它会先写测试,再删注释。
4. 不放心,找影响范围。
1
/pstack:blast-radius 这个 branch 的改动。我最担心改了重试逻辑之后,其他会重试的命令会不会也受影响。
读它找到的“之所以安全的那一个事实”有没有被证明,以及“合并之前”那段建议的测试。
5. 开 PR,等整批完成后再 babysit。
1
/pstack:poteto-mode 开 PR。整理成小而有顺序的 commit,证据写进说明。
1
/pstack:poteto-mode babysit 这个 PR,让它全部通过。
babysit 会处理 CI 和审查留言,到 GitHub 判定可以合并时停下来。合并由你按。
这个例子是逐一手动调用每一步,好让你掌握每个环节。第 1 步明确要求暂停,因此第 2 步才需要另外启动修正。平常你可以把目标和完成条件交给
/pstack:poteto-mode,它会依 playbook 自己决定要用哪些 skill;只有想改变默认做法时,才点名某个 skill。
什么时候用哪个
| 情况 | 用哪个 |
|---|---|
| 有一个用户反馈的 bug 要修 | /poteto-mode + 症状 +“先重现”(Bug fix playbook) |
| 要加一个新功能 | /poteto-mode + 行为 + 什么不能变(Feature playbook) |
| 想先看到一个会失败的测试再修 | /tdd(要有低成本的本地测试路径) |
| README、PR 说明读起来像 AI 写的 | /unslop |
| diff 里有一堆注释,送审之前 | /no-comments |
| 一个小 diff,不放心会不会弄坏别处 | /blast-radius |
| 量了一个性能数字,要写进 PR | /benchmark-checklist |
| AI 没办法自己启动、操作你的程序 | /create-verification-skill(做一次,commit 进项目) |
| 代码改了,验证 skill 可能过时 | /maintain-verification-skill |
| 重试、并行、状态机这类测试很难碰到的情况 | /create-formal-verification-skill |
| 改好了,要开 PR | /poteto-mode + “开 PR”(其他 playbook 结束时会自动接) |
| PR 有 CI 失败或审查留言要处理 | /poteto-mode +“babysit”;只想看状态就问“看一下” |
| 要合并 | 你自己按;要 AI 合并得明确说,走 Shipping |
注意事项
- 完成条件写在第一个提示:没有具体的检查,AI 只能交出一个“感觉做完了”。
- “无法判断”不是通过:在错的界面验证、或检查跑不了,都要被标出来,不要当成成功。
- 单元测试不等于 bug 不见了:修 bug 要在原本出问题的界面重跑一次重现步骤。
- 不要硬写测试:
/tdd宁可不加测试,也不要加坏测试。 - 开 PR 不会自动 babysit:等整批 PR 都开好再调用,免得一直重跑检查。
- babysit 不会合并:到可以合并就停,合并是另一个决定。
- babysit 第一次运行会下载依赖包:见上面的提醒。
- 验证 skill 要维护:代码改了,记得跑
/maintain-verification-skill。 - 版本:以上依 pstack
0.15.36的说明文件整理,之后的版本可能会改变做法。
结论
用 pstack 把代码推到可以合并,靠的是每一步都留下证据。实现时,修 bug 先重现问题,加功能先说清楚数据形状,完成后都在对应的界面验证;有低成本的测试路径,就用 /tdd 让失败的测试先进 git 历史。送审之前,用 /unslop 清文字、/no-comments 清注释。不放心时,用 /blast-radius 证明改动之所以安全的那个事实;有性能数字,先过 /benchmark-checklist;AI 没办法自己操作你的程序,就用 /create-verification-skill 给它一套方法,并定期维护。最后让开 PR 的 playbook 整理 commit 和说明,再由 babysit 处理 CI 和留言,推到 GitHub 判定可以合并为止。按下合并的,永远是你。
延伸阅读
- 指南:Build the change and clean the diff:各种实现任务的提示写法,以及清理的习惯。
- 指南:Verify the result and open a PR:完成条件、验证 skill、形式验证、开 PR、babysit 和 Shipping。
- 四个 playbook:bug-fix、feature、opening-a-pr、babysit。
- skill 的说明文件:tdd、unslop、no-comments、blast-radius、benchmark-checklist、create-verification-skill、maintain-verification-skill、create-formal-verification-skill。
- pstack 系列(1):安装、选模型,再用 /poteto-mode 挑 playbook:怎么安装、更新,以及
/poteto-mode怎么替任务排顺序。 - pstack 系列(2):改代码之前,先看懂再设计:
/how、/why、/architect、/interrogate、/arena。 - 自己写 Agent Skill:项目专属的 skill 放在哪里、SKILL.md 怎么写。
- 装了第三方 skill 和 MCP 之后,你的 Coding Agent 多了哪些破口?:agent 下载依赖包、读文件时的风险,权限怎么收。
- 另一套 skill 的做法:mattpocock/skills 系列导读、AI 开工写代码前,先决定要看哪一种信号、代码写完之后,谁来看结构、审修改、解冲突。