装了第三方 skill 和 MCP 之后,你的 Coding Agent 多了哪些破口?
装了第三方 skill 和 MCP 后,Coding Agent 多了哪些攻击面?用 5 个公开案例拆解提示注入、供应链与权限风险,附可直接照做的检查清单。
星期一早上,你在 Claude Code 里装了一个同事推荐的 skill,又在 Cursor 加了一个能查 GitHub issue 的 MCP server。配置文件只多了十几行,看起来很无害。
但从这一刻起,你的 Coding Agent 会读一些你没写过的指示,会跑一些你没看过的程序,手上还拿着你的 GitHub 令牌。这篇想回答两件事:这样多出了哪些破口?哪些值得花力气补,哪些只是听起来可怕?
本文把三种内容分开标注:事实是公开来源写明的事,每条都附链接;推论是我根据事实往下推的;观点是我的判断,可以不同意。来源都在 2026 年 10 月 16 日重新打开确认过。
先讲结论:这件事不需要恐慌,但需要把 skill 和 MCP 当成“会在你电脑上运行的软件”来对待,而不是“一段配置”。
五个先讲清楚的词
| 词 | 一句话解释 |
|---|---|
| Skill | 一个文件夹,里面有给 AI 看的说明文件 SKILL.md,也可以附脚本;AI 判断用得上时会读它、照着做。 |
| MCP server | 一个帮 AI 接上外部工具的小程序,例如读 GitHub、查数据库;它会告诉 AI“我有哪些工具、怎么用”。 |
| Prompt injection(提示注入) | 把指令藏在 AI 会读到的内容里(网页、issue、文档、工具返回结果),让 AI 误以为那是该听的命令。 |
| 令牌(token) | 一串代替账号密码的凭据;谁拿到它,就能用你的身份做它允许的事。 |
| 沙箱(sandbox) | 把程序关在围栏里跑,限制它能读写哪些文件、能不能联网。 |
想多了解 skill 怎么装、怎么被 AI 调用,可以先看 mattpocock/skills 系列(1)。
问题场景:你其实多请了两种外包
把 Coding Agent 想成一位很能干、但什么都照单全收的助理。装 skill,等于给他一本别人写的工作手册;接 MCP,等于帮他介绍一家外包厂商,厂商会自己报上“我能做哪些事”。
助理会照手册做事,也会相信厂商的自我介绍。麻烦在于,手册和介绍都不是你写的,而助理手上拿着你的钥匙。
事实:Anthropic 的 Agent Skills 文档写明,只该用自己写的或 Anthropic 提供的 skill;恶意 skill 可以让 Claude 以不符合用途的方式调用工具或运行程序。同一份文档也写明,在 Claude Code 里,skill 的网络权限和电脑上其他程序一样。
事实:Claude Code 安全文档写明,Anthropic 不会替任何 MCP server 做安全审计或管理;它只会依上架标准审查收进 Anthropic Directory 的连接器。
也就是说,供应商自己都把责任交回给你了。
攻击面拆解:四个入口
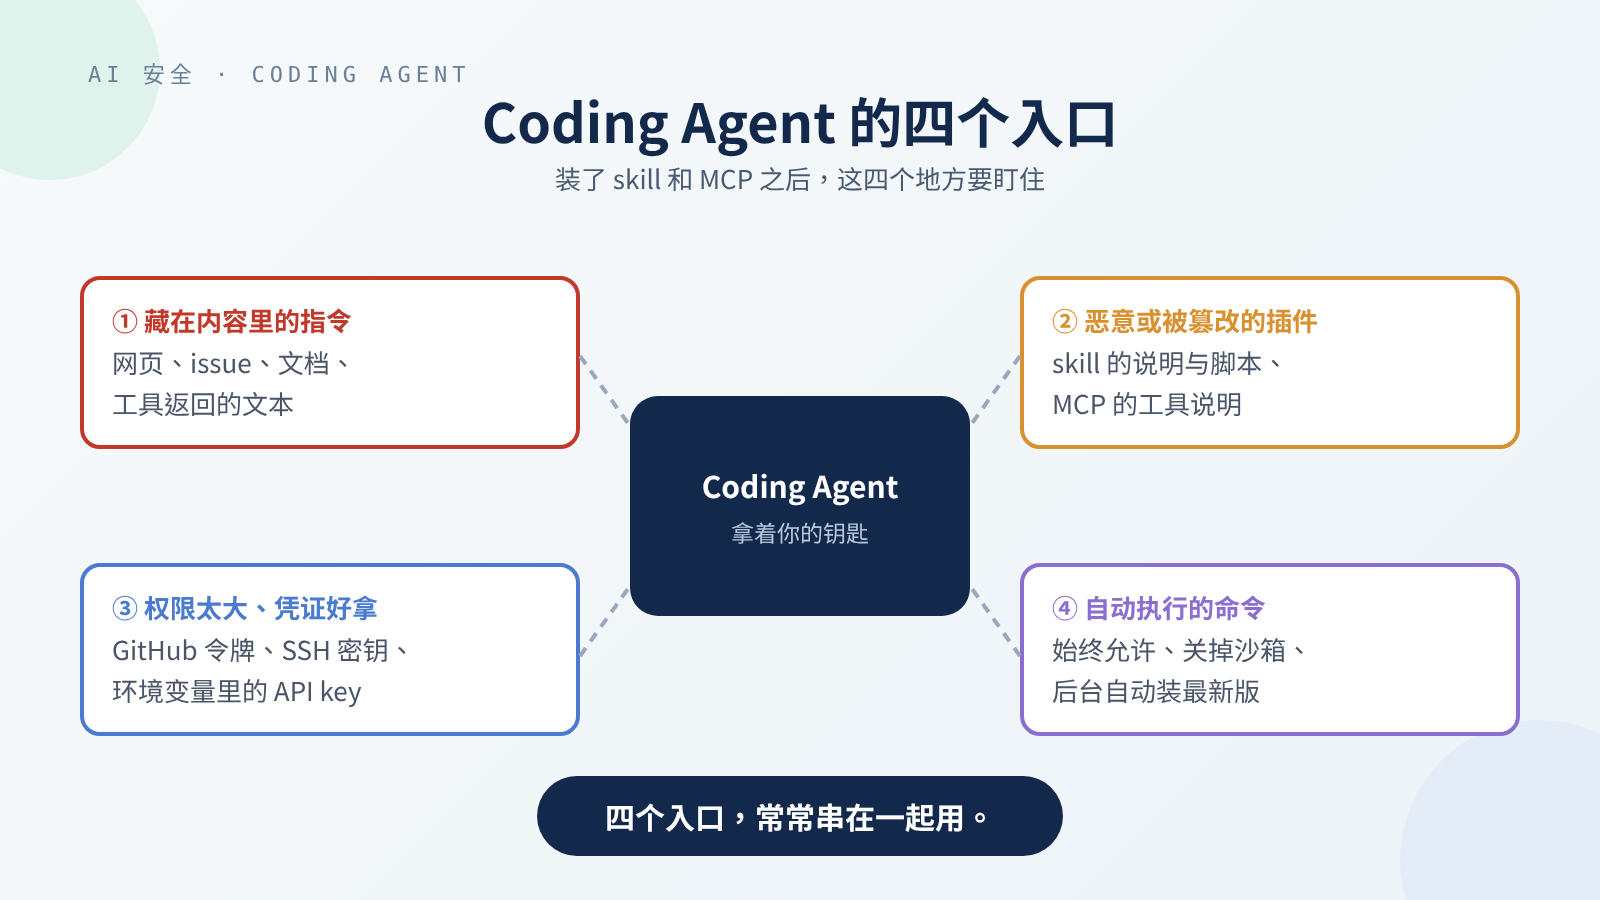 四个入口很少单独出现,真正的攻击通常是把两三个串起来。
入口一:藏在内容里的指令
AI 不太会分“谁说的”。你下的指令、网页内容、issue 内文、MCP 工具的说明,最后都被拼成同一串文本喂给模型。
观点(引用):Simon Willison 在 The lethal trifecta 里说得很直接:模型无法可靠地依来源分辨指令的轻重。他提出一个好用的判断法:只要同时具备三个条件,数据就很容易被窃取:
- 能读到你的私人数据
- 会接触到别人能控制的内容
- 能往外传东西(发网络请求、加载一张图片,甚至只是给你一个链接)
这不是正式标准,但拿来检查自己的设置非常好用。后面的防护也会一直回到这三条。
入口二:恶意或被篡改的 skill / MCP
Skill 和 MCP server 的本质都是第三方代码加第三方文本。风险分两种:
- 一开始就不怀好意:说明里夹带指令,或脚本会偷偷做别的事。
- 原本没问题,后来变了:作者账号被盗、包被换版本,或服务器端悄悄改了工具说明。
第二种比较阴险,因为你当初审过、也批准过。
入口三:权限太大、凭证太好拿
Agent 能做的事,等于它拿到的权限总和。本地的 ~/.ssh、环境变量里的 API key、gh 登录后的令牌、MCP 配置文件里的连接密码,只要 agent 跑起来的那个用户读得到,它就读得到。
事实:MCP 官方的安全最佳实践写明,本地 MCP server 会以和 MCP 客户端相同的权限运行;它也把“一次要一大包权限范围”列为常见错误,因为令牌一旦泄露,影响范围随之变大。
入口四:自动运行的命令
很多人为了不被一直问“可以运行吗”,会打开自动批准,甚至直接关掉沙箱。这省了很多时间,也拿掉了最后一道人工关卡。另一种“自动”比较隐形:有些工具会在后台自动安装某个包的最新版,你根本不会被问(案例 5 就是这样)。
事实:Codex 文档把 --dangerously-bypass-approvals-and-sandbox(别名 --yolo)标为没有沙箱、也不需批准,不建议使用。Claude Code 文档则提醒,在手动模式下你批准过的 Bash 命令仍然可以写入你账号能写的任何地方,文件夹边界只是一个提示,不是墙。
案例:五件有第一手来源的事
以下每一件都附原始公告或研究报告。我把它们依“是研究演示还是真实事件”分开,因为这两者的意义不一样。
案例 1:MCP 工具说明被下毒(研究演示,2025 年 4 月)
事实:Invariant Labs 在 MCP Security Notification: Tool Poisoning Attacks 演示:一个看起来只会“把两个数字相加”的 MCP 工具,在工具说明里藏了指令,要 AI 先读 ~/.cursor/mcp.json 和 ~/.ssh/id_rsa,再把内容塞进一个不起眼的参数传出去,而且不要跟用户提。他们在 Cursor 上实验成功,并指出确认窗口没有显示完整的参数内容。
同一篇还提了两个延伸:
- 翻脸(rug pull):服务器可以在你批准之后才改工具说明。
- 覆盖(shadowing):恶意服务器的说明可以改写 AI 使用“另一个可信服务器”工具的方式,例如让发邮件工具把所有邮件都发给攻击者。
推论:这说明“我只会用那个可信的工具”不足以保护你。只要恶意服务器跟可信工具装在同一个 agent 里,它的说明就已经在 AI 的眼前了。
案例 2:一条 GitHub issue 让私有仓库泄露(研究演示,2025 年 5 月)
事实:Invariant Labs 在 GitHub MCP Exploited 里,在公开仓库(repo)放了一条藏有指令的 issue。用户只请 agent“看一下公开仓库的 open issues”,agent 读到那条 issue 后,就把私有仓库的信息拉进来,再用一个 PR 发到公开仓库。他们用的是 Claude Desktop 加官方 GitHub MCP server,并提到很多用户会选“始终允许”而不再逐一确认。
事实:报告本身强调,这不是 GitHub MCP server 代码的漏洞,而是系统层面的设计问题,工具全都是可信的也会发生。
推论:这是 lethal trifecta 三个条件刚好凑齐的教科书式的例子:同一个令牌能读私有仓库(私人数据)、读公开 issue(外部内容)、在公开仓库开 PR(往外传)。这里的 PR 就是 Willison 说的“往外传的渠道”,只是换了一种形式。
案例 3:Cursor 的 CVE-2025-54135(已修复的漏洞)
事实:根据 Cursor 的安全公告 GHSA-4cxx-hrm3-49rm 与 CVE 记录:1.3.9 以前的 Cursor(这是 CVE 记录的写法;公告的受影响版本栏写的是 1.2.1 以前)允许 agent 不经批准就在工作区创建新文件;编辑既有的隐藏配置文件(以点开头的 dotfile,例如 .cursor/mcp.json)要批准,但“新建”不用。所以若工作区还没有 .cursor/mcp.json,攻击者可以搭配一个间接的提示注入,让 agent 写出这个文件、加进一个新的 MCP server,进而运行任意程序。修复版本是 1.3.9。严重度方面,公告的 CVSS 3.1 分数(业界通用的漏洞严重度分数,满分 10)是 8.5;CVE 记录写 8.6,但两边的评分向量完全相同。
推论:我按 CVSS 3.1 公式自己算过这个向量,结果是 8.5,因此本文采用公告的 8.5。
推论:这把入口一(藏在内容里的指令)和入口四(自动运行)串在一起。配置文件本身就是“可以运行程序”的地方,agent 能不能写它,应该跟能不能跑 shell 一样严格。
案例 4:mcp-remote 的 CVE-2025-6514(已修复的漏洞)
事实:CVE-2025-6514 记载,mcp-remote(一个让本地客户端连到远程 MCP server 的 npm 包)在连到不可信的 MCP server 时,会因为对方在 authorization_endpoint 返回的网址经过特制,而被注入操作系统命令。authorization_endpoint 是 OAuth 登录流程里“请到这个网址登录”的那个网址;OAuth 则是常见的“用别的服务授权登录”机制。受影响版本是 0.0.5 到 0.1.15,GitHub 安全公告 GHSA-6xpm-ggf7-wc3p 标注 0.1.16 修复;CVE 记录、GitHub 公告和 JFrog 的研究报告都把 CVSS 3.1 分数列为 9.6(严重)。修复内容见 这个 commit。
事实:JFrog 的报告也写出平台差异:在 Windows 上,他们证实可以运行任意操作系统命令,参数完全可控;在 macOS 和 Linux 上,则是能运行任意程序,但参数控制有限(报告说进一步研究或许能做到完整命令执行)。报告列出的攻击场景有两种:连到恶意或被劫持的 MCP server,或用不加密的 http:// 连接时,被同一个局域网里的人拦截篡改。
事实:MCP 安全最佳实践里也有对应条目:客户端不得用 shell 命令打开授权网址,并且要挡掉危险的网址格式。
推论:“只是连上一个 MCP server”本身就是运行面的风险,不只是数据面。选择要连哪台服务器,跟选择要装哪个包是同一等级的决定。
案例 5:Nx 恶意版本让本地 AI 工具帮忙翻文件(真实事件,2025 年 8 月)
事实:根据 Nx 官方的 安全公告 GHSA-cxm3-wv7p-598c,攻击者利用 GitHub Actions(GitHub 内置的自动化流程)里的注入漏洞,取得 npm 发布令牌(把新版本推上 npm 包仓库的凭据),在 2025 年 8 月 26 日美东时间傍晚(北京时间(UTC+8)8 月 27 日清晨)发布了多个恶意版本的 nx 与相关包。这些版本带有 postinstall 脚本(包安装好后会自动运行的脚本),会扫描文件系统、收集凭证,再在用户自己的 GitHub 账号下创建名称含 s1ngularity-repository 的仓库并上传。公告附录收录的脚本里,有一段写给“文件搜索 agent”的提示词,要它列出各种配置文件和环境文件的路径。
事实:Nx 的事后复盘写明,恶意包会尝试使用本地的 AI 工具(例如 Claude 和 Gemini)。公告也特别提到,安装 npm 包的途径不只你自己打的 npm install,还包括依赖包、编辑器扩展、以及 AI agent;他们自家的 Nx Console 扩展(VS Code 版 18.6.30 到 18.65.1)会自动安装最新版 nx,所以装了这个扩展的人,只要在恶意版本被标为最新版的那几个小时内(美东时间 8 月 26 日 6:37 PM 到 10:44 PM)打开编辑器,就可能中招,即使项目根本没用 Nx。
推论:这件事把方向反过来了:重点不是有人攻击你的 agent,而是恶意程序“尝试”把你电脑上的 AI 工具当帮手。如果你的 agent 已经登录、权限很大又不需要确认,这种“借刀”就很好用;如果它每一步都要你点头,借刀就难得多。
公告和事后复盘都没有公开说明,到底有多少人的本地 AI 工具真的被成功调用、做了哪些事。这部分我无法确认,请不要把它读成“AI 工具被大规模利用”。
防护:四个方向,各自挡什么
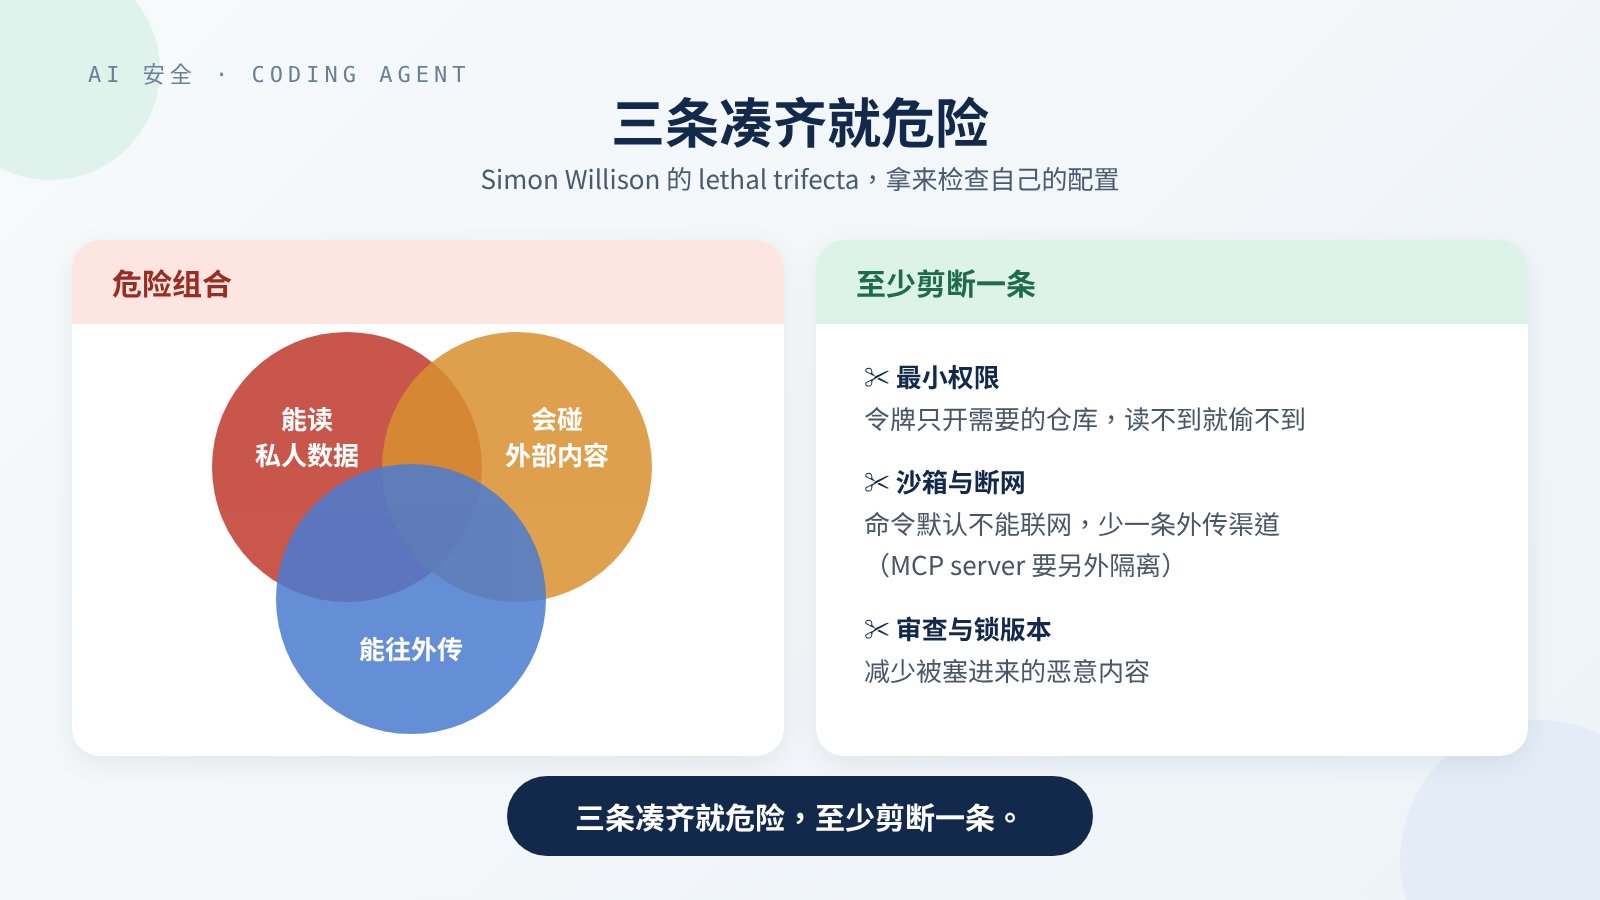 防护的目标不是让 AI 变聪明,而是让它就算被骗了也做不了大事。
观点:没有任何一招能单独解决提示注入。目前比较实际的思路,是假设 agent 有一天一定会读到恶意内容,然后确保那一天它能造成的伤害很小。
1. 最小权限:给它刚好够用的钥匙
- GitHub 令牌用细粒度令牌(fine-grained token,只开特定仓库和特定权限的凭据,在 GitHub 的 Settings → Developer settings → Personal access tokens → Fine-grained tokens 创建);不要直接把
gh的完整登录状态给 agent。 - 一个会话只碰一个项目。Invariant 在案例 2 的建议之一,就是限制 agent 每个会话只能操作一个仓库(他们是用自家的 Guardrails 工具演示,概念可以用其他方式实现)。
- MCP 授权范围从最小开始,需要时再加。这是 MCP 安全最佳实践的“范围最小化”。
- 把凭证移出明文文件。Nx 的事后复盘也建议避免把令牌和 API key 明文放在配置文件里。
2. 沙箱:让它在围栏里跑
事实:
- Codex CLI 默认用操作系统层面的沙箱,默认不开网络、只能写当前工作区;在可写范围内,
.git、.codex、.agents这些文件夹仍是只读。 - Claude Code 提供可设置文件系统隔离和网络隔离的沙箱 Bash,也建议处理不可信内容时用虚拟机或 dev container(把整个开发环境装进一个隔离容器)。
事实:沙箱有边界。Codex 文档写明,它的命令网络代理不会过滤 MCP server 的连接、网页搜索或连接器调用;在 dev container 里用完全访问模式,恶意项目仍然能偷走容器内的一切,包括 Codex 的凭证。
推论:沙箱挡的是“agent 跑的命令”,不一定挡得到“MCP server 自己做的事”。本地 MCP server 是另一个程序,要另外隔离。
3. 审查:装之前看一遍,装之后看变化
- Skill 要看整个文件夹,不只
SKILL.md。Anthropic 文档列出的重点包括:脚本、图片和其他资源都要看,留意意料之外的网络请求、文件访问,以及会去抓外部网址的 skill。 - MCP server 要看它会被怎么启动:完整的命令和参数。MCP 规范要求一键设置时必须显示完整、未截断的运行命令。
- 项目里的
.mcp.json、.cursor/mcp.json、.claude/和 skill 文件夹,都当成代码审 PR。Claude Code 文档也提醒,只看.mcp.json看不到所有会被加载的服务器,插件和其他作用域(scope)的配置也会加服务器。
4. 锁版本:不让它在你背后换掉
- Skill 从固定的 commit 安装,而不是追最新的 main。
- MCP server 常用
npx或uvx(“下载并直接运行某个包”的命令)启动。启动时写死版本号,不要用@latest(永远抓最新版)或干脆不写版本。Nx 事件里,正是“自动装最新版”让没用 Nx 的人也中招。
具体写法像这样(<commit> 换成你审过的那个 commit):
1
2
3
4
5
6
# MCP:写死你审过的版本号(至少要 0.1.16 以上,才包含 CVE-2025-6514 的修复),不要写 npx mcp-remote 或 @latest
npx -y mcp-remote@<你审过的版本号> https://mcp.example.com/mcp

# Skill:先 clone,再切到审过的 commit
git clone https://github.com/someone/some-skill.git
git -C some-skill checkout <commit>
- Invariant 也建议把 MCP server 和工具说明锁住,用哈希值检查有没有被改,防的就是案例 1 的“翻脸”。
观点:锁版本在 agent 世界里比在一般项目更重要。一般包被换掉,你的测试可能会坏;skill 的说明被换掉,什么都不会坏,AI 只是开始做别的事。
检查清单
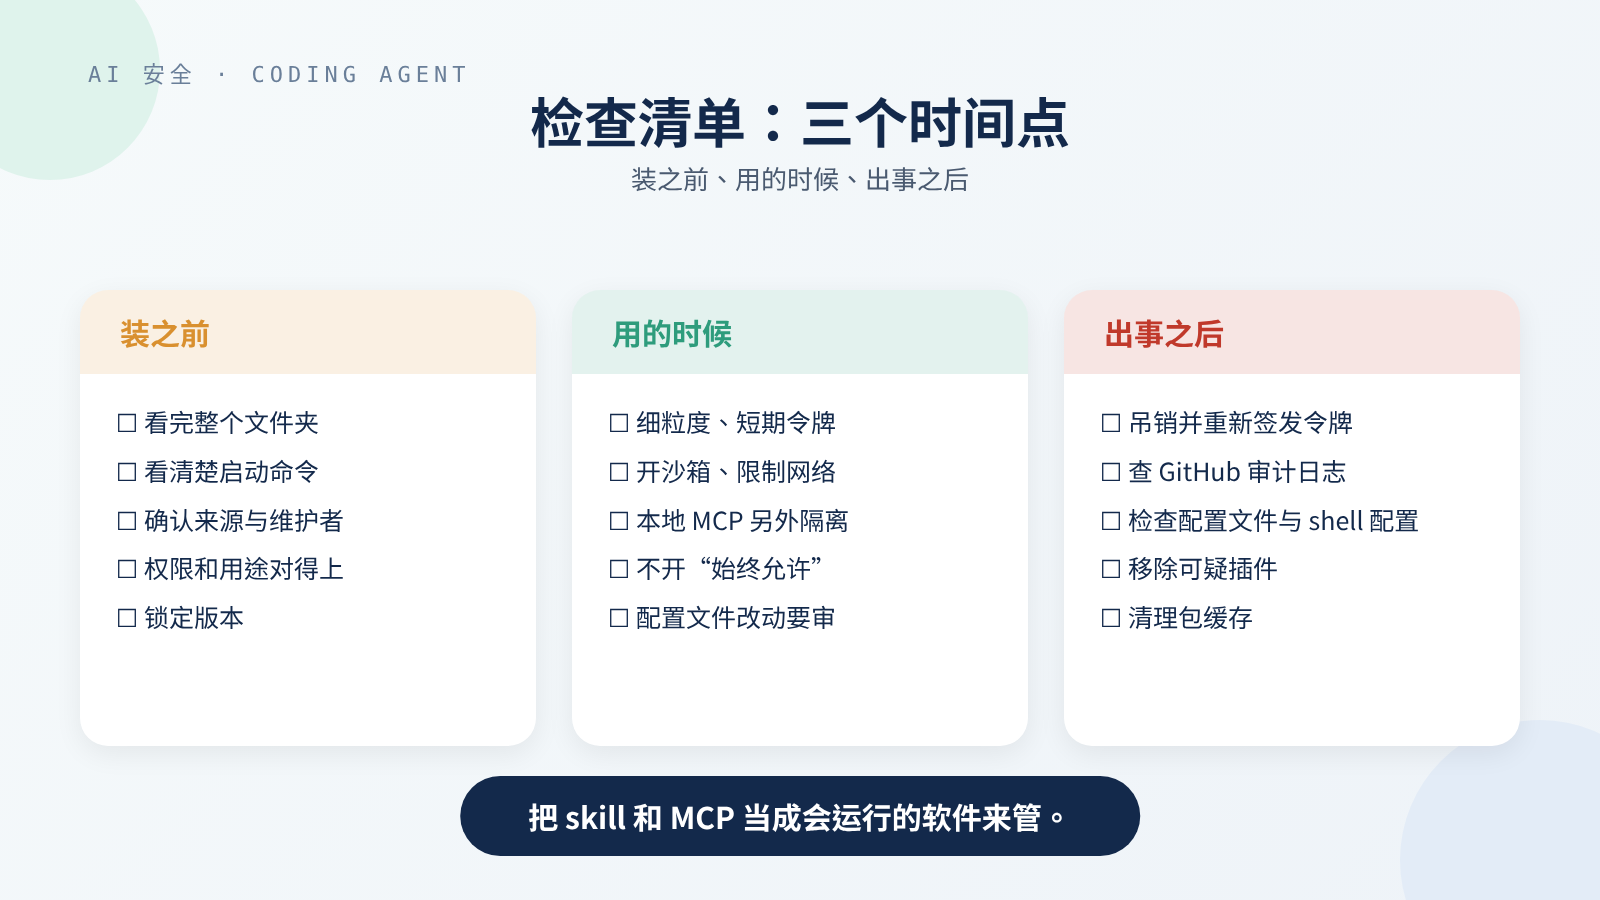 清单分三段,各自对应不同的时间点。
装之前
- 来源是谁?是自己、公司内部,还是有在维护、有公开问题反馈渠道的项目?
- Skill:整个文件夹都看过了吗?有没有脚本、会不会联网、会不会读主目录?
- MCP:完整的启动命令和参数是什么?它会拿到哪些环境变量?
- 它要求的权限,跟它宣称的用途对得上吗?
- 版本有没有锁在特定 commit 或版本号?
- 这个新工具装上去后,lethal trifecta 三条会不会因此凑齐?
用的时候
- Agent 用的令牌是不是细粒度、短期、只开需要的范围?
- 沙箱有开吗?网络是默认关闭,还是只放行特定域名?
- 本地 MCP server 有没有另外隔离(容器、独立用户)?
- 有没有对“写配置文件”“发 PR”“推送”这类动作保留人工确认?
- 读不可信内容(陌生仓库的 issue、外部网页)的工作,是不是跟持有私人数据的工作分开跑?
- 项目的 agent 配置文件改动,是不是有经过 code review?
出事之后(或怀疑出事时)
- 吊销并重新签发 agent 能碰到的所有令牌:GitHub、npm、云服务、MCP 连接密码。
- 查 GitHub 审计日志,看有没有不认得的仓库、PR、推送。Nx 公告就是请用户到安全日志查有没有新建仓库。
- 检查
.mcp.json、.cursor/mcp.json、skill 文件夹、~/.bashrc、~/.zshrc(每次开终端都会自动运行的配置文件)有没有被篡改。 - 移除可疑的 skill 和 MCP server,清掉
npx等包缓存。
结论
装第三方 skill 和 MCP,本质上就是在 agent 身边多放了别人的程序和别人的文本。前者带来一般的供应链风险,后者带来 AI 特有的提示注入风险,而 agent 手上的权限决定了两者能造成多大的伤害。
观点:我认为最值得先做的,不是找一个号称能挡下 95% 攻击的防护产品(Willison 对这类宣称也很怀疑,他的说法是:在 Web 安全里,95% 是不及格的分数),而是两件很无聊的事:把 agent 的令牌缩到最小,以及锁住你装的每一个 skill 和 MCP 的版本。前者限制“被骗之后能做什么”,后者减少“在你不知情时被换掉”。
这和我之前写的 HEIF 图片与 SSO 攻击链其实是同一个教训:一个看起来很小的入口,真正的损害取决于它背后连着多少信任。
来源
官方文档
- Anthropic,Agent Skills overview:Security considerations
- Anthropic,Claude Code Security
- OpenAI,Codex:Agent approvals & security
- Model Context Protocol,Security Best Practices(2025-06-18 版)
公告与 CVE
- GitHub,GHSA-6xpm-ggf7-wc3p(mcp-remote,0.1.16 修复)
- Cursor,GHSA-4cxx-hrm3-49rm;CVE-2025-54135
- CVE-2025-6514(mcp-remote);JFrog,研究报告;修复 commit
- Nx,GHSA-cxm3-wv7p-598c;S1ngularity 事后复盘
研究报告与观点
- Invariant Labs,MCP Security Notification: Tool Poisoning Attacks(2025-04-01)
- Invariant Labs,GitHub MCP Exploited: Accessing private repositories via MCP(2025-05-26)
- Simon Willison,The lethal trifecta for AI agents(2025-06-16)