mattpocock/skills 系列(4):AI 开工写代码前,先决定要看哪一种信号
工作单准备好后,AI 会同时写代码与测试。本文说明 implement、tdd、diagnosing-bugs 与 prototype 各自靠什么判断做对了,并用按席位计费的例子实际跑一轮从红灯到绿灯的测试。
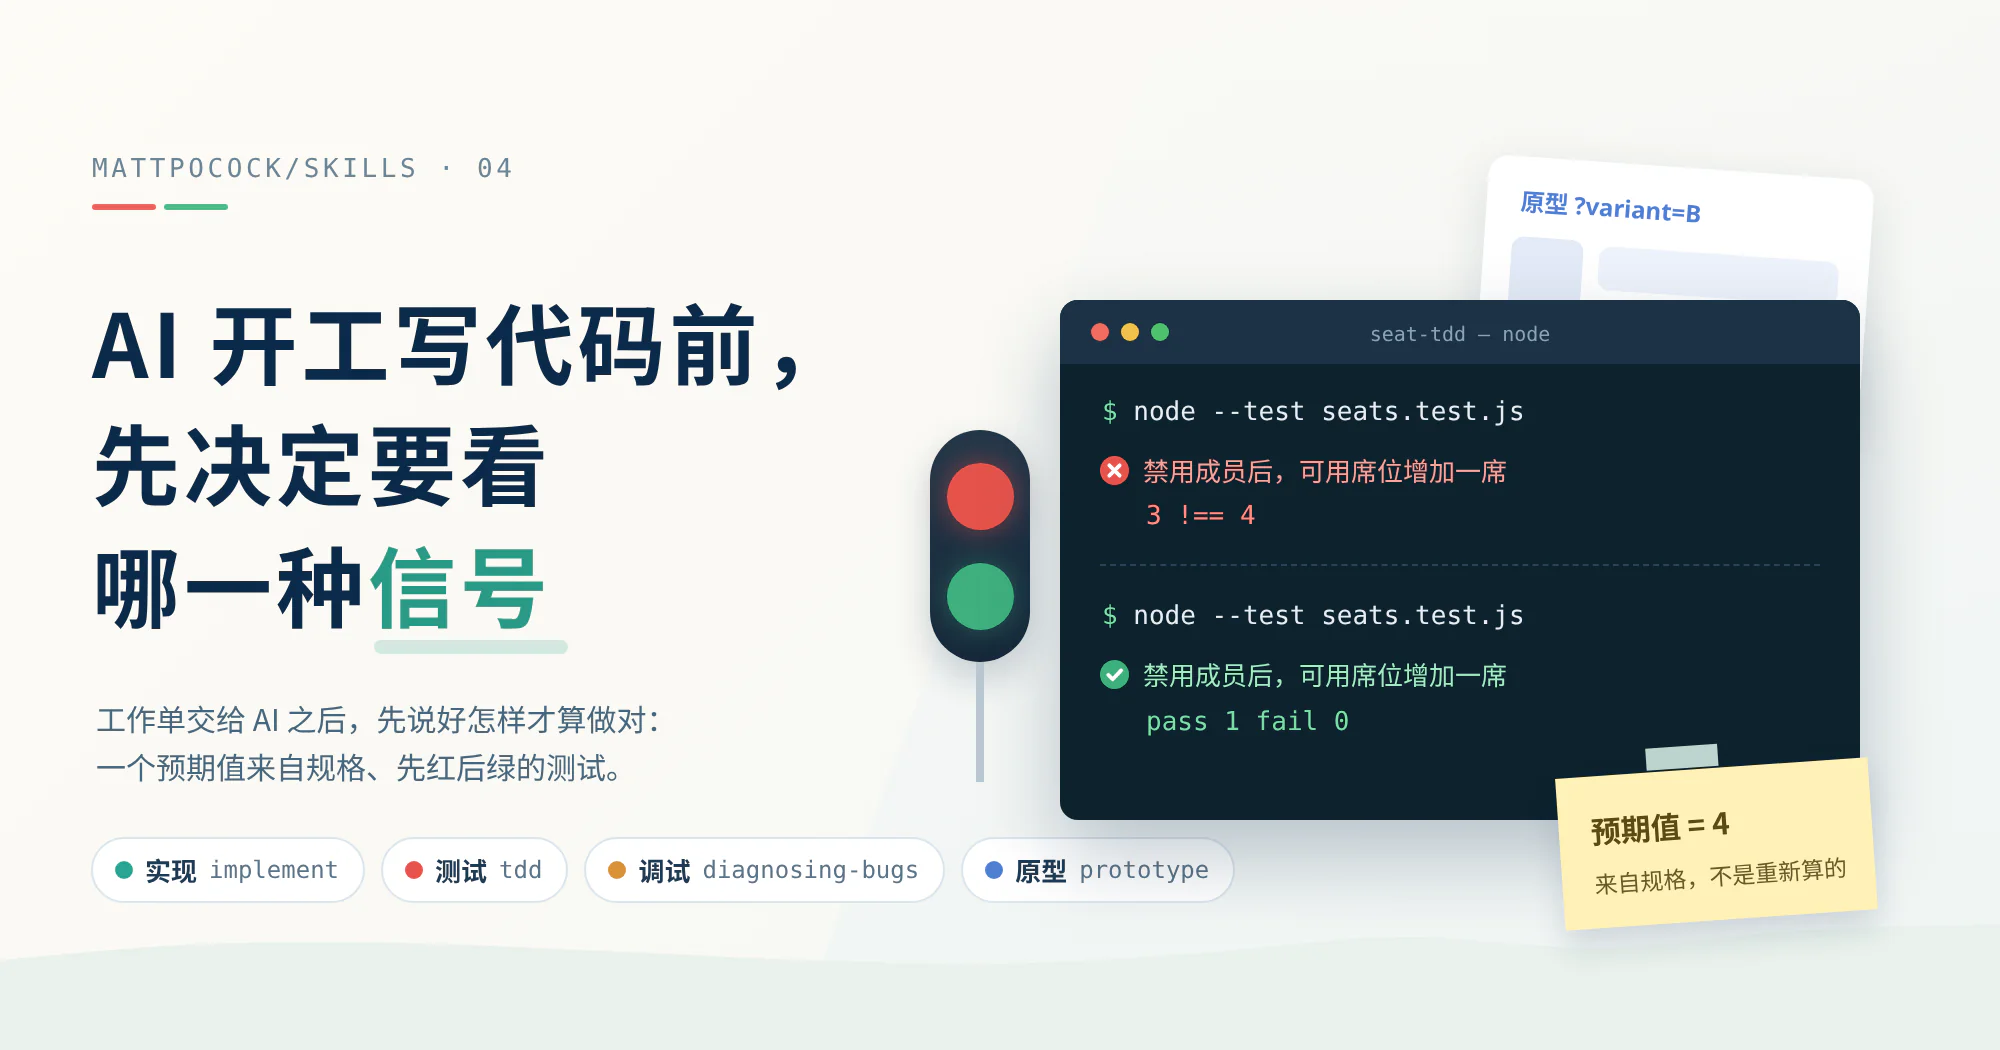
在上一篇的推演里,to-tickets 把按席位计费切成三张工作单,每张都打上了 ready-for-agent,表示信息已经齐全,可以交给 AI 接手。现在要开一个新的对话,让 AI 实现其中一张“禁用成员并释放席位”。它会自己改代码、自己写测试,最后报告“测试全部通过”。
可是这些测试也是 AI 写的,它可能只是在替自己刚写的代码背书,根本没对照需求。代码和测试都由 AI 写,你要看什么才知道它做对了?
mattpocock/skills 把这一段交给四个 skill:implement、tdd、diagnosing-bugs 与 prototype。每个 skill 判断“做对了”所看的信号都不一样。
mattpocock/skills 系列|第 4 篇
- 上一篇(第 3 篇):先找出缺口,再决定要写规格还是拆工作单
- 下一篇(第 5 篇):代码写完之后,谁来看结构、审修改、解冲突
- 系列导读:这套 skill 是什么、六篇该怎么读
按席位计费的 skill 调用流程是我依原始指令推演的;文中的红灯与绿灯测试输出,则是我实际运行的结果。
版本提醒(2026-10-19 核实):这篇以
1.2.3版为准。mattpocock/skills已于 2026-10-04 发布1.3.0和1.3.1,本文介绍的四个 skill 都还在,但有三点不同:
- 原本仍在试验中的
implement-spec移入了官方插件。它会一次实现整份规格,用 worktree(同一个 repo 的多个工作目录)并行处理多张工作单,是逐张使用implement之外的另一种做法。- 同样移入官方插件的
retro是主线的最后一步,在code-review之后回顾这次工作。tdd、diagnosing-bugs读取的词汇表从CONTEXT.md改名为GLOSSARY.md。另外,从
1.3.1起,ask-matt会在修完 bug 后建议运行retro。这个系列之后我会按新版全面更新。
先认识几个词
下面几个词会反复出现:
| 本文用词 | 原文 | 意思 |
|---|---|---|
| 红灯、绿灯 | red、green | 测试失败显示红色,通过显示绿色。先写一个会失败的测试,再写刚好让它通过的代码,这一来一回就是一轮 |
| 测试接缝 | seam | 从外面观察程序行为的公开入口,例如一个对外提供的函数。测试只从这里进去,不碰内部细节 |
| 反馈回路 | feedback loop | 一条可以反复运行、立刻告诉你“对”或“错”的命令,例如一次测试或一个脚本 |
| 原型 | prototype | 只为了回答一个设计问题而写、之后不会直接上线的代码 |
四个 skill 各看一种反馈信号
这四个 skill 都放在 repo 的 skills/engineering/ 底下,许可证是 MIT。它们在 ask-matt 路线图上的位置不同:
flowchart LR
  G[grill-with-docs 谈需求] -->|对话谈不定| P[prototype]
  P -->|带回答案| G
  G --> T[to-spec、to-tickets]
  T --> I["implement + tdd"]
  I --> R[code-review]
  B[东西坏了] --> D[diagnosing-bugs]
图中的位置出自 ask-matt 的主流程、专门处理“东西坏了”的入口,以及只靠对话谈不定设计问题时才走的岔路。implement 实现每张工作单时都搭配 tdd,完成后再跑 code-review。code-review 负责审查这次修改的代码,第 5 篇我会介绍。
四个 skill 判断做对了的依据各不相同:
| skill | 靠什么判断做对了 |
|---|---|
implement | 类型检查、测试,以及最后的 code-review |
tdd | 事先确认的测试接缝上,一个先红后绿的测试 |
diagnosing-bugs | 一条已经对这个 bug 亮过红灯的命令 |
prototype | 由人实际点过或看过之后的反应 |
implement 把工作单交给测试与审查
implement 是四个 skill 里最短的一个。扣掉文件开头的 front matter 设置区块,整份指令只有五行:
1
2
3
4
5
6
7
8
9
Implement the work described by the user in the spec or tickets.

Use /tdd where possible, at pre-agreed seams.

Run typechecking regularly, single test files regularly, and the full test suite once at the end.

Once done, use /code-review to review the work.

Commit your work to the current branch.
逐行看下来,AI 会做下面五件事:
- 读你指定的规格或工作单,按照内容实现。
- 能用
tdd的地方就用,而且只在事先谈好的测试接缝上写测试。 - 过程中经常跑类型检查与单一测试文件,整套测试只在最后跑一次。
- 做完后调用
code-review审查这次的修改。 - 把成果 commit 到当前分支。
第 3 点要留意:整套测试只在最后跑一次,所以这张工作单没有动到的测试文件,要到最后才会运行。如果这次修改不小心弄坏了别处的功能,也要到那时才会发现。
implement 不会自己启动,要由你明确调用,AI 不会因为聊到“开始写吧”就自行运行它。这是因为它有两个设置:
- front matter 设置了
disable-model-invocation: true。 agents/openai.yaml写了allow_implicit_invocation: false。
功能要分好几次对话才做得完时,ask-matt 建议每张工作单各跑一次 implement,两张之间清空对话内容。因为每张工作单已经写明所需信息,上一张的对话不必保留。
tdd 先约定在哪里测,再一次只做一小段
implement 的第二行把测试交给 tdd。tdd 先处理“在哪里测”,再处理“怎么测”。
它的规则要求 AI 在写任何测试之前,先列出准备测试的接缝,并请你确认。原文的理由是不可能每个地方都测,先谈好接缝,测试才会集中在最重要的流程与最复杂的逻辑上。
AI 开始探索代码时,若项目里有 CONTEXT.md 就先读,让测试名称沿用项目的共用词汇。这份词汇表就是第 2 篇用 grill-with-docs 留下的那一份。
接缝确认后,才进入红绿循环:
flowchart TD
  A[列出测试接缝] --> B{你确认了?}
  B -->|否| A
  B -->|是| C[写一个测试,看它亮红灯]
  C --> D[写刚好让它通过的代码]
  D --> E{还有要测的行为?}
  E -->|有,接缝已确认| C
  E -->|需要新的接缝| A
  E -->|没有| F["重构留到 code-review"]
循环规则有三条:
- 先红后绿。 只写刚好让这个测试通过的代码,不替后面还没写的测试预先做准备。
- 一次一小段。 每一轮只处理一个接缝、一个测试与一份最小实现。
- 重构不在循环里。 重构是指不改变程序行为、只整理写法,这件事留到
code-review阶段再做。
tdd 另外点名三种反模式:
| 反模式 | 长什么样子 | 会出什么问题 |
|---|---|---|
| 绑死实现细节 | 模拟自己的内部模块、测试私有方法,或绕过接口直接查数据库 | 程序行为没变、只是整理了写法,测试却坏了 |
| 同义反复 | 预期值用和程序一模一样的算法重算一遍 | 测试怎样都会通过,永远不会和程序唱反调 |
| 水平切分 | 先把所有测试写完,再一次写完所有实现 | 测到的是想象中的行为;还没动手实现,测试的架构就先定死了 |
第三种的解法是垂直切分:一个测试配一份实现,再进下一轮,每一轮都根据上一轮学到的东西调整。上一篇 to-tickets 切工作单用的 tracer bullet 概念,在这里又出现一次,只是尺度缩小到单一测试。
要模拟的对象也有限制。mocking.md 只允许在系统边界使用替身,替身是用假的对象顶替程序原本依赖的东西。系统边界是程序与外界接触的地方,例如付款或发邮件等外部服务、时间与随机数;自己写的模块与内部组件不用替身。
diagnosing-bugs 先做出会亮红灯的命令
tdd 处理“还没写的代码”,diagnosing-bugs 处理“已经坏掉的代码”。它的第一阶段直接写着“This is the skill”,意思是整个 skill 的重点就在这一步。在做出一条会对这个 bug 亮红灯的命令之前,AI 不准开始推测原因。
有了这条命令,才进入后面五个阶段:
flowchart TD
  A[做出会亮红灯的命令] --> B{做得出来?}
  B -->|否| S[停下来向你要环境或日志]
  B -->|是| C[复现并缩小]
  C --> D[提出 3 到 5 个假设]
  D --> E[加观察点逐一验证]
  E --> F{找得到测试接缝?}
  F -->|是| G[先写回归测试再修复]
  F -->|否| H[improve-codebase-architecture]
  G --> I[清理]
原文列出十种做法,大致依次尝试。排在最前面的几种是:
- 一个会失败的测试
- 对开发服务器发请求的脚本
- 带固定输入的 CLI 命令
- 操作浏览器的脚本
排在最后的是 scripts/hitl-loop.template.sh,只有在一定要人动手点界面时才用。这个模板提供两个函数:step 显示一步操作并等你按 Enter,capture 把你输入的观察结果记下来。最后它把结果输出为 KEY=VALUE,交回给 AI。
第一阶段有四项完成条件。AI 必须提出一条已经实际跑过的命令并贴出运行结果,而这条命令要做到:
- 会走到出错的代码路径,并检查用户反馈的那个症状。
- 每次运行的结果都一样。
- 几秒内跑完。
- AI 可以自己运行,不必等人在旁边操作。
偶尔才出现的 bug 不求每次复现,目标是把复现率拉高。原文举例,复现率 50% 的 bug 还追得下去,1% 就追不了。
真的做不出回路时,AI 要停下来列出试过的方法,再向你要以下其中一项:
- 能复现问题的环境
- 脱敏后的日志文件
- 在生产环境暂时加上监控的许可
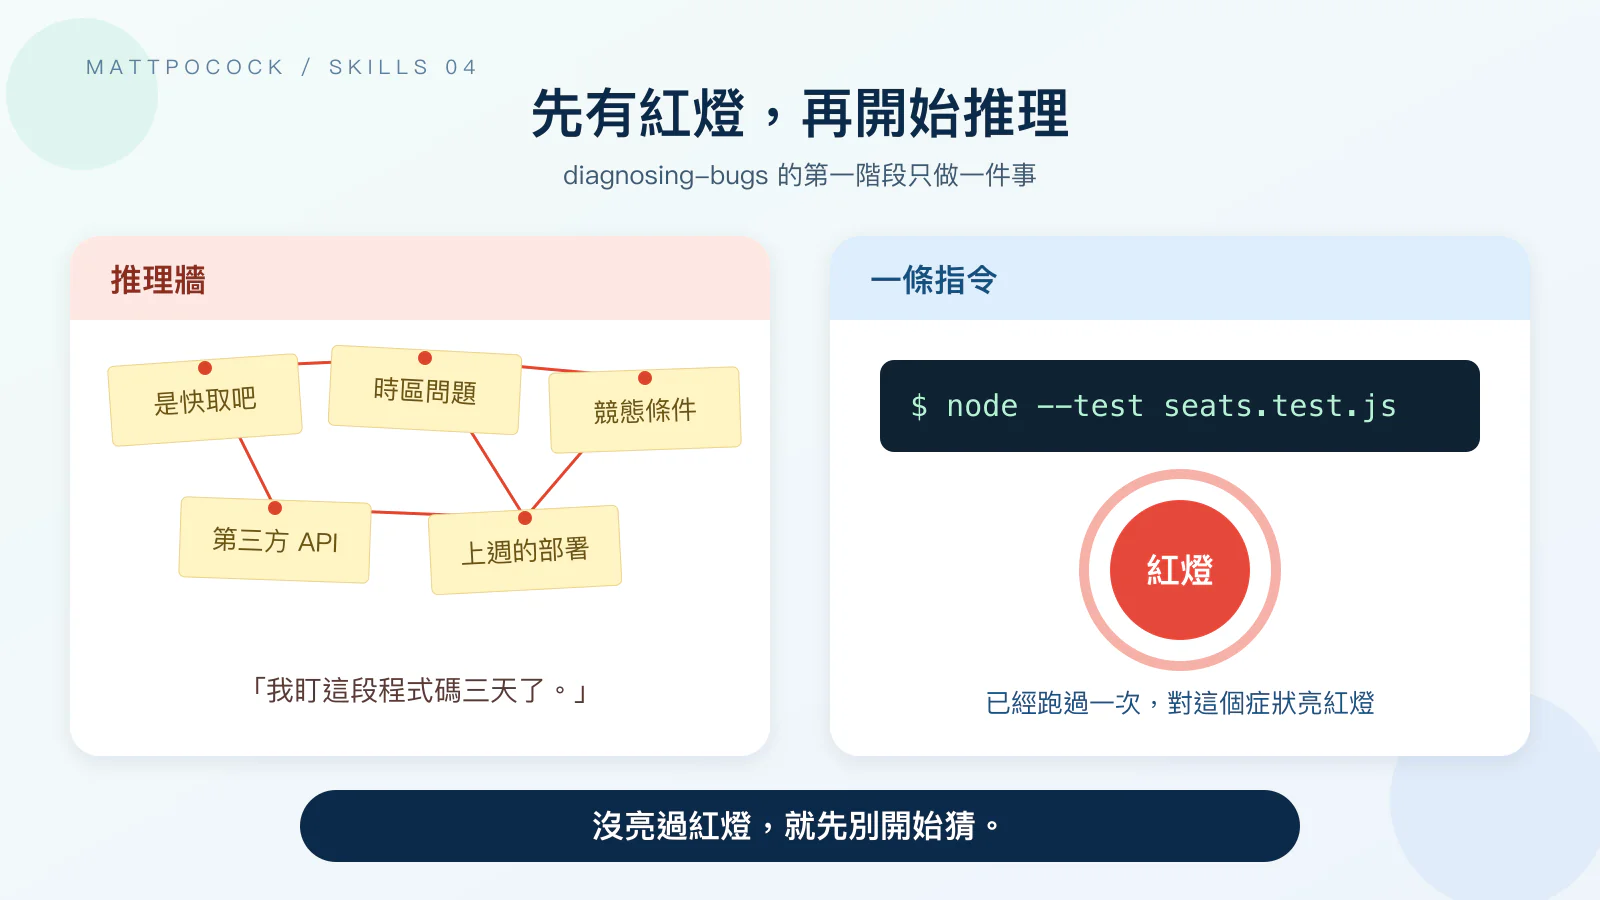 还没有会亮红灯的命令,推测再多也无法确认哪一个对。
有了回路之后,其余五个阶段各有要做到的事:
- 复现并缩小。 确认亮红灯的是用户反馈的那个症状,再每次拿掉一项输入或步骤,直到剩下的每一项都缺一不可。
- 提出假设。 一次列出 3 到 5 个排过优先级的假设,每个都写明它预测会发生什么,并先给你看。你不在时,AI 照自己的排序继续。
- 加入观察点。 观察点是在代码里打印出中间值等调试输出。每个观察点对应一个假设,一次只改一个变量。调试用的输出一律加上像
[DEBUG-a4f2]这样的前缀,结束时搜索一次就能全部删掉。 - 修复并补回归测试。 回归测试用来确认同一个 bug 不会再出现,要先写一个会失败的回归测试,再修复。前提是找得到正确的测试接缝。如果找不到,也说明了一件事:现在的代码结构没办法用测试挡住这个 bug 再次出现。这时
ask-matt把后续交给improve-codebase-architecture,下一篇我会介绍。 - 清理。 重跑原本的回路、确认回归测试通过、删掉
[DEBUG-开头的输出,并把最后证实的假设写进 commit 或 PR 说明。
第 2 步的假设要写成“如果原因是 X,那么改变 Y 会让 bug 消失”,写不出预测的假设要丢掉或改写。套在席位上,我会写成“如果原因是禁用时没有把成员移出已分配名单,那么在禁用流程补上移除动作,可用席位就会正确增加”。
prototype 用一次性程序回答一个设计问题
前三个 skill 都能靠命令判断对错,但有些设计问题得让人亲手试过,才会发现哪里不对。例如:成员被禁用后又要重新激活,工作区却刚好没有可用席位了,这时该怎么处理?
prototype 一开头就写明,原型是回答一个问题的一次性程序,要回答什么问题,就决定原型做成什么样子。它分成两条路:
| 要回答的问题 | 产物 | 怎么使用 |
|---|---|---|
| 这套逻辑或状态模型对不对 | 一个独立的 HTML 文件,双击就能开 | 按按钮推动状态,看每一步后的完整状态 |
| 这个界面该长什么样子 | 同一个 URL 路径上的数个版本,用 ?variant= 切换 | 用界面底部的浮动栏左右切换版本 |
逻辑原型要写给不写代码的人使用。LOGIC.md 要求按钮与状态都用领域语言标注,界面分成三块:
- 当前状态
- 可以自由操作的按钮
- 分成多个标签页的引导场景
每个场景都从同一个初始状态开始,整组场景要覆盖顺利的流程、棘手的边界情况,以及一个应该被拒绝的操作。用来回答问题的那段逻辑,要写成一个不碰网页元素的独立模块,问题解决后可以直接搬进生产代码。
界面原型默认做 3 个版本,最多 5 个。版本之间要有结构上的差异,例如布局、信息层次或主要操作方式不同。
UI.md 说,三个只稍微调整过的卡片网格不是原型,只是壁纸:看起来各有花色,却没有回答任何设计问题。它也建议把版本直接放进现有页面,因为页面周围的真实数据与导航栏才能暴露设计问题。
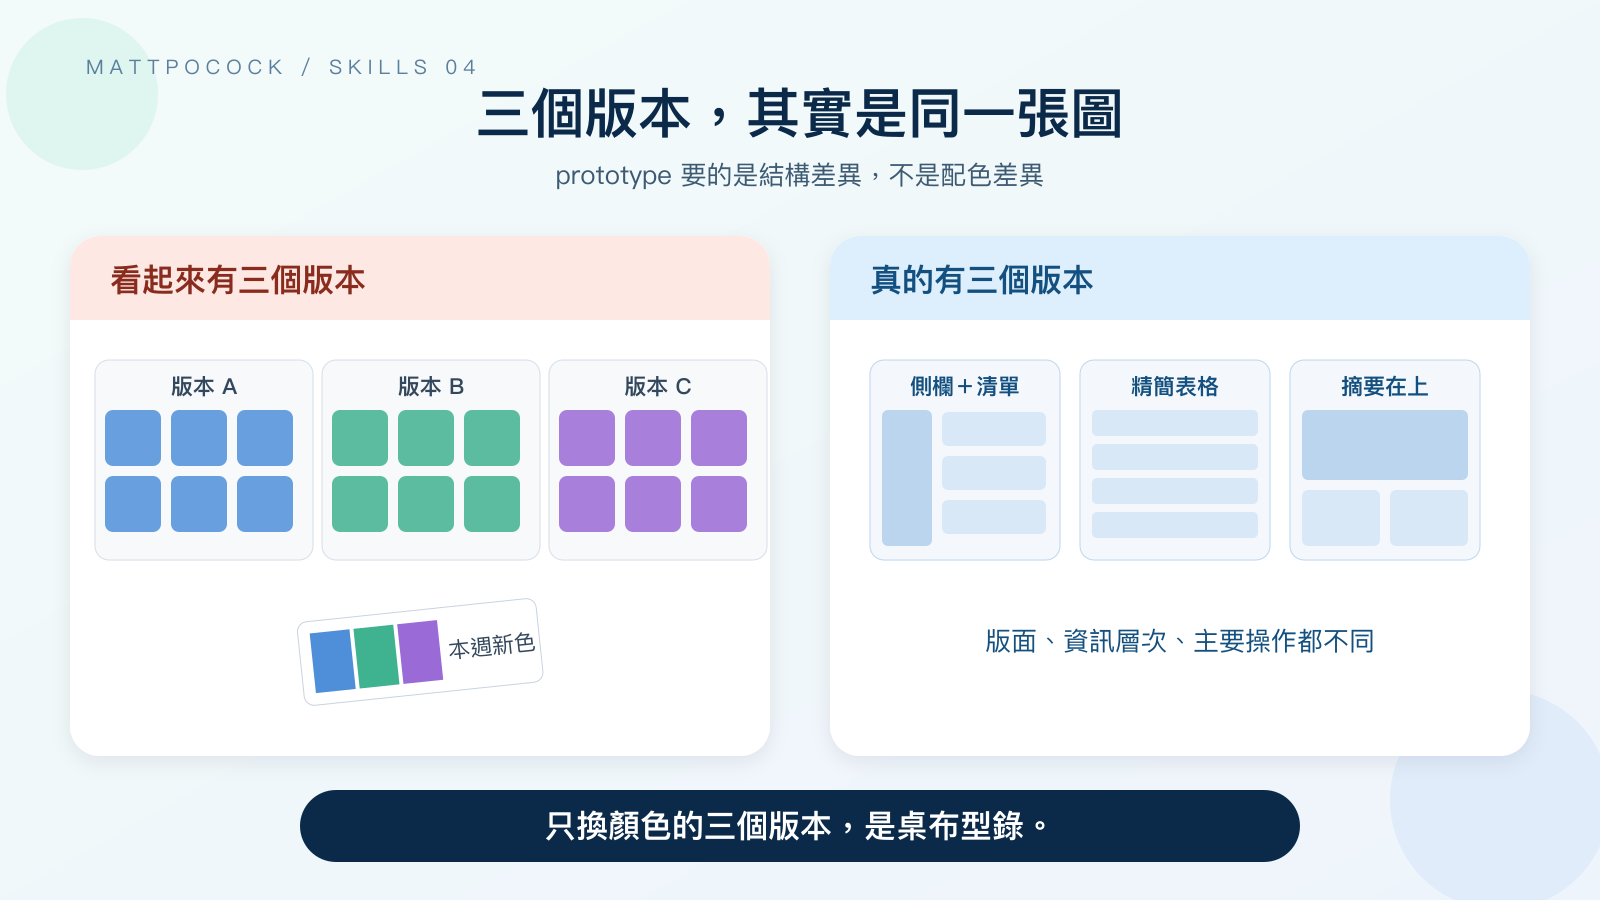 版本之间要在布局与操作方式上有所不同,只换颜色看不出设计差异。
两条路共用六条规则:
- 原型从第一天就标明是抛弃式。
- 一条命令或双击就能启动。
- 默认不存数据。
- 不写测试与错误处理。
- 每次操作后都把完整状态显示出来。
- 收尾时,验证过的决定写进生产代码。原型本身则 commit 到主线以外的抛弃式分支,并在实现工作单上留下指向该分支的说明。
ask-matt 把这个分支命名为 prototype/<name>。主线只留下验证过的结论。
测试由 AI 自己写,靠两条规则才算数
开头问过:AI 自己写代码也自己写测试,测试会不会只是在替程序背书?tdd 靠两条规则防止这种情况。
第一条是测试位置由你确认。 前面提过,AI 列出的接缝要经过你同意,才能在那里写测试。我建议趁这一步,把“禁用成员后可用席位增加”这类需求里写明的行为,指定为一定要验证的项目。
第二条是预期值要有独立来源。 tdd 在说明同义反复这个反模式时,要求预期值来自程序以外的依据,例如已知正确的数值、手算过的例子或规格。tests.md 用同一个求和函数示范了两种写法:
1
2
3
4
5
6
7
8
9
10
11
// BAD: Expected value is recomputed the way the code computes it
test("calculateTotal sums line items", () => {
  const items = [{ price: 10 }, { price: 5 }];
  const expected = items.reduce((sum, i) => sum + i.price, 0);
  expect(calculateTotal(items)).toBe(expected);
});

// GOOD: Expected value is an independent, known literal
test("calculateTotal sums line items", () => {
  expect(calculateTotal([{ price: 10 }, { price: 5 }])).toBe(15);
});
第一种写法的 expected 用 reduce 重算一次。程序怎么算,测试就怎么算,所以它永远会通过。第二种写法直接写 15,这个数字可以拿规格或手算核对,所以程序算错时测试就会失败。
不过,这两条规则都只是写在 Markdown 里的指令,没有机制强制执行。我看过 tdd 文件夹,里面没有任何检查脚本。整个文件夹只有 SKILL.md、tests.md、mocking.md 与一份 agents/openai.yaml。
AI 列出接缝时,你若没细看就按同意,第一条规则等于没有作用。所以我认为,测试算不算数,要你自己看两样东西:你确认过的接缝清单,以及每个预期值能不能在规格里找到出处。
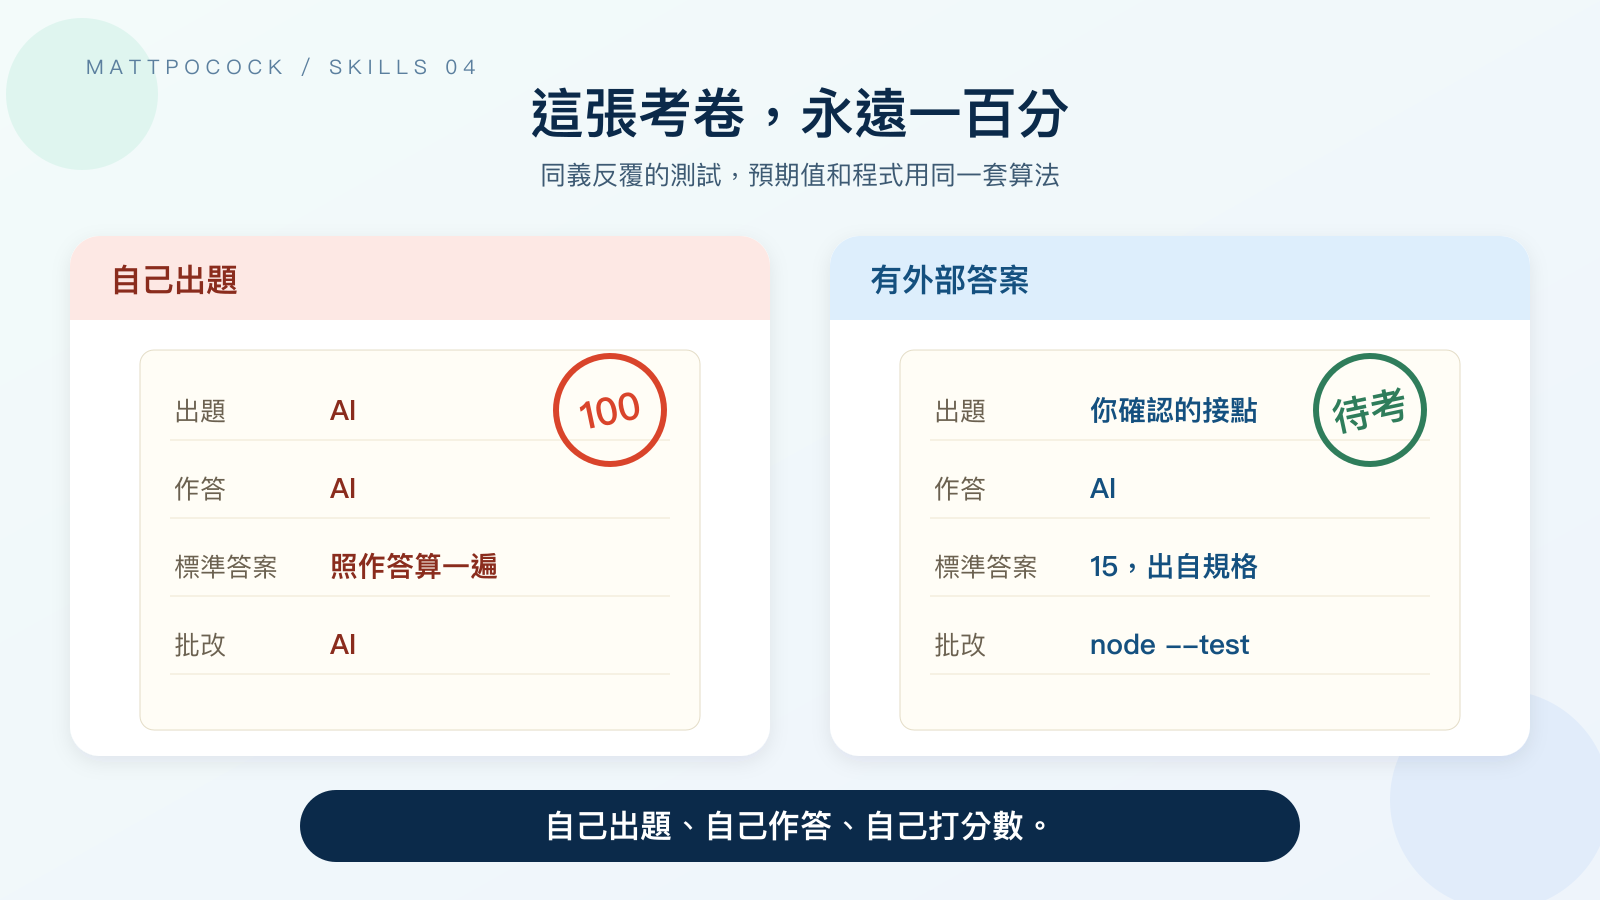 预期值若照程序的算法重算,测试就会永远通过。
哪些地方要花你的时间
这四个 skill 让你不必再凭感觉判断做完了没。但照我的整理,下面这些环节都要有人付出心力,多半落在你身上:
| 环节 | 由谁付出 | 付出什么 |
|---|---|---|
调用 implement | 你 | 每张工作单手动调用一次,两张之间清空对话 |
tdd 写测试前 | 你 | 逐一检查 AI 列出的测试接缝 |
implement 收尾 | AI 与你 | 跑完整套测试与 code-review,你要看审查结果 |
diagnosing-bugs 第一阶段 | AI,必要时是你 | 原文要求在这里投入不成比例的精力;做不出回路时,要由你提供环境或日志 |
diagnosing-bugs 提出假设 | 你 | 看一遍假设排序,补上你知道的背景 |
prototype 交付后 | 你或领域专家 | 实际点过每个场景或每个版本,并说出哪里不对 |
prototype 收尾 | 团队 | 维护 prototype/<name> 分支,并在工作单上留下指向它的说明 |
在我看来,最花时间的是 diagnosing-bugs 的第一阶段。原文认为回路做对了,bug 就等于修好了九成,所以时间都花在这里。
什么情况用哪一个
我建议照你手上的状况挑:
| 你手上的状况 | 使用的 skill | 不适用的时候 |
|---|---|---|
有打上 ready-for-agent 的规格或工作单 | implement | 还没有规格或工作单时,先回到 to-spec,或单独用 tdd |
| 没有规格,只想先写测试、再做出一个具体功能 | tdd | 连公开接口该长什么样都还没定,就先用 codebase-design 的词汇讨论接口 |
| 功能报错、结果错误或变慢,第一眼找不到原因 | diagnosing-bugs | 做不出会亮红灯的命令时,AI 会停下来向你要环境或日志,不会直接猜 |
| 状态模型或界面,只靠对话判断不了 | prototype | 问题能在对话中谈定时,留在 grill-with-docs 继续问 |
模拟场景:实现“禁用成员并释放席位”
以下流程是我依 1.2.3 版的原始指令推演的。其中的红灯与绿灯测试,我在 Node.js v25.2.1 上实际跑过;程序是我为这篇写的最小示例,并非取自 mattpocock/skills。
假设前两张工作单“显示工作区已购买与可用席位”与“把可用席位分配给成员”都已完成。你开一个新的对话,附上第三张工作单:
1
$implement <禁用成员并释放席位的工作单链接>
AI 读完工作单与 CONTEXT.md 后,会依 tdd 的规则先列出测试接缝。例如“工作区对外提供的 deactivateMember() 与 availableSeats()”。你要确认两件事:
- 这两个函数是不是其他程序实际会调用的入口。
- 验收条件里的“可用席位增加一席”能不能从这里观察到。
你同意后,AI 写下第一个测试。预期值的依据是规格里的“测试决定”字段:禁用成员后,可用席位要增加一席。以买了 5 席、分配 2 席为例,禁用其中一人后,可用席位要是 4。
把下面内容存成 seats.test.js:
1
2
3
4
5
6
7
8
9
10
11
12
13
import { test } from "node:test";
import assert from "node:assert/strict";
import { createWorkspace, assignSeat, deactivateMember, availableSeats } from "./seats.js";

test("禁用成员后,可用席位增加一席", () => {
  const workspace = createWorkspace({ purchasedSeats: 5 });
  assignSeat(workspace, "alice");
  assignSeat(workspace, "bob");

  deactivateMember(workspace, "alice");

  assert.equal(availableSeats(workspace), 4);
});
此时的 seats.js 只有前两张工作单完成的部分,deactivateMember() 还是空的:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
export function createWorkspace({ purchasedSeats }) {
  return { purchasedSeats, assigned: new Set() };
}

export function assignSeat(workspace, memberId) {
  workspace.assigned.add(memberId);
}

export function deactivateMember(workspace, memberId) {
  // 尚未实现
}

export function availableSeats(workspace) {
  return workspace.purchasedSeats - workspace.assigned.size;
}
在同一个文件夹放一份内容为 { "type": "module" } 的 package.json,接着运行单一测试文件:
1
node --test seats.test.js
结果亮红灯,实际可用席位是 3,预期是 4:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
✖ 禁用成员后,可用席位增加一席 (0.92075ms)
ℹ tests 1
ℹ suites 0
ℹ pass 0
ℹ fail 1
...
✖ failing tests:

test at seats.test.js:5:1
✖ 禁用成员后,可用席位增加一席 (0.92075ms)
  AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:

  3 !== 4

      at TestContext.<anonymous> (file:///<已屏蔽路径>/seat-tdd/seats.test.js:12:10)
...
红灯代表这个测试抓得到“禁用后没有释放席位”的问题。接着只写刚好让它通过的代码,也就是把 // 尚未实现 换成一行:
1
2
3
export function deactivateMember(workspace, memberId) {
  workspace.assigned.delete(memberId);
}
再跑一次同一条命令,结果转成绿灯:
1
2
3
4
5
6
7
8
9
✔ 禁用成员后,可用席位增加一席 (0.343958ms)
ℹ tests 1
ℹ suites 0
ℹ pass 1
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 43.76225
这只完成了一轮。工作单的验收条件还包括“计费系统收到新的席位数量”,但它不在刚才确认的接缝清单里。所以 AI 要先把计费系统这个接缝补进清单、请你确认,再继续下一轮,每轮一个测试。
全部完成后,implement 跑完整套测试、调用 code-review,再 commit 到当前分支。你要看的是审查结果,以及每个测试的预期值能不能对照规格。
如果之后收到“禁用成员后,可用席位没有增加”的反馈,上面那条 node --test 就是 diagnosing-bugs 第一阶段要的回路。它对这个症状亮过红灯,而且从上面的 duration_ms 看,不到 50 毫秒就跑完,符合“几秒内跑完”的条件。
implement 的质量取决于工作单
这一节是我自己的看法,原始资料没有直接这样说。
implement 没有说工作单写得模糊时该停下来问谁,也没有规定验收条件不完整时怎么处理。它只把“在事先谈好的接缝上测试”交给 tdd。而那些接缝与预期值,大多早在 to-spec 确认检查点、to-tickets 写下验收条件时就决定了。
所以我不会期待 implement 补救一张切得不好的工作单。AI 列出的接缝若对不上验收条件,或预期值在规格里找不到,我会暂停实现,回到 grill-with-docs 或 to-spec 把缺的内容补齐。
这个看法只适用于照这套流程先写规格、再切工作单的项目。单独用 tdd 做一个小功能时,接缝与预期值是在当下的对话里直接谈定的,没有事先写好的规格或工作单可以回头补。
接下来
判断 AI 做对了没,要看它自己改不了的东西。换到你自己的项目,可以开一个新的对话,照模拟场景的命令,对一张已打上 ready-for-agent、没有前置工作的工作单运行 implement。AI 列出测试接缝时逐一确认;它写出测试后,再核对每个预期值都能在规格里找到。
下一篇介绍代码写完之后的四个 skill:
codebase-design与improve-codebase-architecture:看代码结构。code-review:审查这次的修改。resolving-merge-conflicts:解决合并冲突。
延伸阅读
implement:五行指令全文。tdd:接缝确认规则、三种反模式与红绿循环。tdd/tests.md:好测试与坏测试的对照示例。diagnosing-bugs:十种构建回路的方法与各阶段的完成条件。prototype:逻辑原型与界面原型怎么分流、做完要保留什么。