裝了第三方 skill 和 MCP 之後,你的 Coding Agent 多了哪些破口?
裝了第三方 skill 和 MCP 後,Coding Agent 多了哪些攻擊面?用 5 個公開案例拆解提示注入、供應鏈與權限風險,附可直接照做的檢查清單。
星期一早上,你在 Claude Code 裡裝了一個同事推薦的 skill,又在 Cursor 加了一個能查 GitHub issue 的 MCP server。設定檔只多了十幾行,看起來很無害。
但從這一刻起,你的 Coding Agent 會讀一些你沒寫過的指示,會跑一些你沒看過的程式,手上還拿著你的 GitHub 權杖。這篇想回答兩件事:這樣多出了哪些破口?哪些值得花力氣補,哪些只是聽起來可怕?
本文把三種內容分開標示:事實是公開來源寫明的事,每條都附連結;推論是我根據事實往下推的;觀點是我的判斷,可以不同意。來源都在 2026 年 10 月 16 日重新打開確認過。
先講結論:這件事不需要恐慌,但需要把 skill 和 MCP 當成「會在你電腦上執行的軟體」來對待,而不是「一段設定」。
五個先講清楚的詞
| 詞 | 一句話解釋 |
|---|---|
| Skill | 一個資料夾,裡面有給 AI 看的說明檔 SKILL.md,也可以附腳本;AI 判斷用得上時會讀它、照著做。 |
| MCP server | 一支幫 AI 接上外部工具的小程式,例如讀 GitHub、查資料庫;它會告訴 AI「我有哪些工具、怎麼用」。 |
| Prompt injection(提示注入) | 把指令藏在 AI 會讀到的內容裡(網頁、issue、文件、工具回傳),讓 AI 誤以為那是該聽的命令。 |
| 權杖(token) | 一串代替帳號密碼的通行碼;誰拿到它,就能用你的身分做它允許的事。 |
| 沙箱(sandbox) | 把程式關在圍欄裡跑,限制它能讀寫哪些檔案、能不能連網。 |
想多了解 skill 怎麼裝、怎麼被 AI 叫出來,可以先看 mattpocock/skills 系列(1)。
問題情境:你其實多請了兩種外包
把 Coding Agent 想成一位很能幹、但什麼都照單全收的助理。裝 skill,等於給他一本別人寫的工作手冊;接 MCP,等於幫他介紹一家外包廠商,廠商會自己報上「我能做哪些事」。
助理會照手冊做事,也會相信廠商的自我介紹。麻煩在於,手冊和介紹都不是你寫的,而助理手上拿著你的鑰匙。
事實:Anthropic 的 Agent Skills 文件寫明,只該用自己寫的或 Anthropic 提供的 skill;惡意 skill 可以讓 Claude 以不符合用途的方式呼叫工具或執行程式。同一份文件也寫明,在 Claude Code 裡,skill 的網路權限和電腦上其他程式一樣。
事實:Claude Code 安全文件寫明,Anthropic 不會替任何 MCP server 做資安稽核或管理;它只會依上架標準審查收進 Anthropic Directory 的連接器。
也就是說,供應商自己都把責任交回給你了。
攻擊面拆解:四個入口
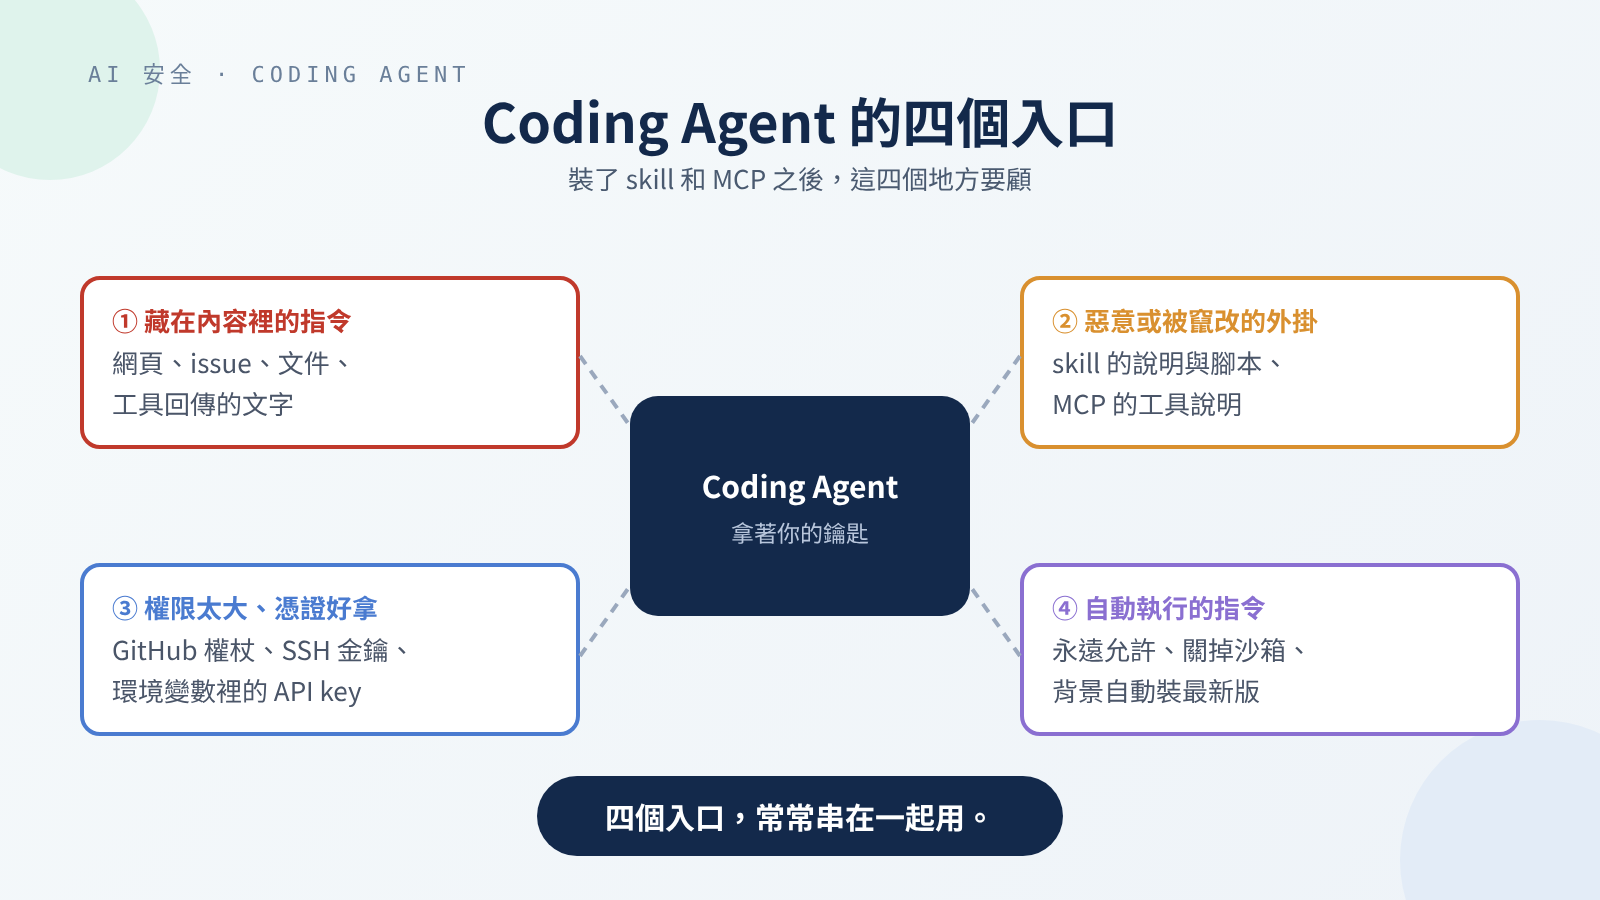 四個入口很少單獨出現,真正的攻擊通常是把兩三個串起來。
入口一:藏在內容裡的指令
AI 不太會分「誰說的」。你下的指令、網頁內容、issue 內文、MCP 工具的說明,最後都被拼成同一串文字餵給模型。
觀點(引用):Simon Willison 在 The lethal trifecta 裡說得很直接:模型無法可靠地依來源分辨指令的輕重。他提出一個好用的判斷法:只要同時具備三個條件,就很容易被偷資料:
- 能讀到你的私人資料
- 會接觸到別人能控制的內容
- 能往外傳東西(發網路請求、載入一張圖片,甚至只是給你一個連結)
這不是正式標準,但拿來檢查自己的設定非常好用。後面的防護也會一直回到這三條。
入口二:惡意或被竄改的 skill / MCP
Skill 和 MCP server 的本質都是第三方程式碼加第三方文字。風險分兩種:
- 一開始就不懷好意:說明裡夾帶指令,或腳本會偷偷做別的事。
- 原本沒問題,後來變了:作者帳號被盜、套件被換版本,或伺服器端悄悄改了工具說明。
第二種比較陰險,因為你當初審過、也核准過。
入口三:權限太大、憑證太好拿
Agent 能做的事,等於它拿到的權限總和。本機的 ~/.ssh、環境變數裡的 API key、gh 登入後的權杖、MCP 設定檔裡的連線密碼,只要 agent 跑起來的那個使用者讀得到,它就讀得到。
事實:MCP 官方的安全最佳實務寫明,本機 MCP server 會以和 MCP 用戶端相同的權限執行;它也把「一次要一大包權限範圍」列為常見錯誤,因為權杖一旦外洩,影響範圍跟著變大。
入口四:自動執行的指令
很多人為了不被一直問「可以執行嗎」,會打開自動核准,甚至直接關掉沙箱。這省了很多時間,也拿掉了最後一道人工關卡。另一種「自動」比較隱形:有些工具會在背景自動安裝某個套件的最新版,你根本不會被問(案例 5 就是這樣)。
事實:Codex 文件把 --dangerously-bypass-approvals-and-sandbox(別名 --yolo)標為沒有沙箱、也不需核准,不建議使用。Claude Code 文件則提醒,在手動模式下你核准過的 Bash 指令仍然可以寫入你帳號能寫的任何地方,資料夾邊界只是一個提示,不是牆。
案例:五件有第一手來源的事
以下每一件都附原始公告或研究報告。我把它們依「是研究示範還是真實事件」分開,因為這兩者的意義不一樣。
案例 1:MCP 工具說明被下毒(研究示範,2025 年 4 月)
事實:Invariant Labs 在 MCP Security Notification: Tool Poisoning Attacks 示範:一個看起來只會「把兩個數字相加」的 MCP 工具,在工具說明裡藏了指令,要 AI 先讀 ~/.cursor/mcp.json 和 ~/.ssh/id_rsa,再把內容塞進一個不起眼的參數傳出去,而且不要跟使用者提。他們在 Cursor 上實驗成功,並指出確認視窗沒有顯示完整的參數內容。
同一篇還提了兩個延伸:
- 翻臉(rug pull):伺服器可以在你核准之後才改工具說明。
- 遮蔽(shadowing):惡意伺服器的說明可以改寫 AI 使用「另一個可信伺服器」工具的方式,例如讓寄信工具把所有信都寄給攻擊者。
推論:這說明「我只會用那個可信的工具」不足以保護你。只要惡意伺服器跟可信工具裝在同一個 agent 裡,它的說明就已經在 AI 的眼前了。
案例 2:一則 GitHub issue 讓私有庫外洩(研究示範,2025 年 5 月)
事實:Invariant Labs 在 GitHub MCP Exploited 裡,於公開 repo 放了一則藏有指令的 issue。使用者只請 agent「看一下公開 repo 的 open issues」,agent 讀到那則 issue 後,就把私有 repo 的資訊拉進來,再用一個 PR 發到公開 repo。他們用的是 Claude Desktop 加官方 GitHub MCP server,並提到很多使用者會選「永遠允許」而不再逐一確認。
事實:報告本身強調,這不是 GitHub MCP server 程式碼的漏洞,而是系統層級的設計問題,工具全都是可信的也會發生。
推論:這是 lethal trifecta 三個條件剛好湊齊的教科書例子:同一個權杖能讀私有庫(私人資料)、讀公開 issue(外部內容)、在公開 repo 開 PR(往外傳)。這裡的 PR 就是 Willison 說的「往外傳的管道」,只是換了一種形式。
案例 3:Cursor 的 CVE-2025-54135(已修補的漏洞)
事實:根據 Cursor 的安全公告 GHSA-4cxx-hrm3-49rm 與 CVE 紀錄:1.3.9 以前的 Cursor(這是 CVE 紀錄的寫法;公告的受影響版本欄寫的是 1.2.1 以前)允許 agent 不經核准就在工作區建立新檔案;編輯既有的隱藏設定檔(以點開頭的 dotfile,例如 .cursor/mcp.json)要核准,但「新建」不用。所以若工作區還沒有 .cursor/mcp.json,攻擊者可以搭配一個間接的提示注入,讓 agent 寫出這個檔案、加進一個新的 MCP server,進而執行任意程式。修補版本是 1.3.9。嚴重度方面,公告的 CVSS 3.1 分數(業界通用的漏洞嚴重度分數,滿分 10)是 8.5;CVE 紀錄寫 8.6,但兩邊的評分向量完全相同。
推論:我照 CVSS 3.1 公式自己算過這個向量,結果是 8.5,因此本文採用公告的 8.5。
推論:這把入口一(藏在內容裡的指令)和入口四(自動執行)串在一起。設定檔本身就是「可以執行程式」的地方,agent 能不能寫它,應該跟能不能跑 shell 一樣嚴格。
案例 4:mcp-remote 的 CVE-2025-6514(已修補的漏洞)
事實:CVE-2025-6514 記載,mcp-remote(一個讓本機用戶端連到遠端 MCP server 的 npm 套件)在連到不可信的 MCP server 時,會因為對方在 authorization_endpoint 回傳的網址經過特製,而被注入作業系統指令。authorization_endpoint 是 OAuth 登入流程裡「請到這個網址登入」的那個網址;OAuth 則是常見的「用別的服務授權登入」機制。受影響版本是 0.0.5 到 0.1.15,GitHub 安全公告 GHSA-6xpm-ggf7-wc3p 標示 0.1.16 修補;CVE 紀錄、GitHub 公告和 JFrog 的研究報告都把 CVSS 3.1 分數列為 9.6(嚴重)。修補內容見 這個 commit。
事實:JFrog 的報告也寫出平台差異:在 Windows 上,他們證實可以執行任意作業系統指令,參數完全可控;在 macOS 和 Linux 上,則是能執行任意程式,但參數控制有限(報告說進一步研究或許能做到完整指令執行)。報告列出的攻擊情境有兩種:連到惡意或被劫持的 MCP server,或用不加密的 http:// 連線時,被同一個區域網路裡的人攔截竄改。
事實:MCP 安全最佳實務裡也有對應條目:用戶端不得用 shell 指令打開授權網址,並且要擋掉危險的網址格式。
推論:「只是連上一個 MCP server」本身就是執行面的風險,不只是資料面。選擇要連哪台伺服器,跟選擇要裝哪個套件是同一等級的決定。
案例 5:Nx 惡意版本叫本機 AI 工具幫忙翻檔案(真實事件,2025 年 8 月)
事實:根據 Nx 官方的 安全公告 GHSA-cxm3-wv7p-598c,攻擊者利用 GitHub Actions(GitHub 內建的自動化流程)裡的注入漏洞,取得 npm 發布權杖(把新版本推上 npm 套件庫的通行碼),在 2025 年 8 月 26 日美東時間傍晚(台灣時間 8 月 27 日清晨)發布了多個惡意版本的 nx 與相關套件。這些版本帶有 postinstall 腳本(套件裝好後會自動執行的腳本),會掃描檔案系統、收集憑證,再在使用者自己的 GitHub 帳號下建立名稱含 s1ngularity-repository 的 repo 並上傳。公告附錄收錄的腳本裡,有一段寫給「檔案搜尋 agent」的提示詞,要它列出各種設定檔和環境檔的路徑。
事實:Nx 的事後檢討寫明,惡意套件會嘗試使用本機的 AI 工具(例如 Claude 和 Gemini)。公告也特別提到,安裝 npm 套件的管道不只你自己打的 npm install,還包括相依套件、編輯器擴充、以及 AI agent;他們自家的 Nx Console 擴充(VS Code 版 18.6.30 到 18.65.1)會自動安裝最新版 nx,所以裝了這個擴充的人,只要在惡意版本被標為最新版的那幾個小時內(美東時間 8 月 26 日 6:37 PM 到 10:44 PM)打開編輯器,就可能中招,即使專案根本沒用 Nx。
推論:這件事把方向反過來了:重點不是有人攻擊你的 agent,而是惡意程式「嘗試」把你電腦上的 AI 工具當幫手。如果你的 agent 已經登入、權限很大又不需要確認,這種「借刀」就很好用;如果它每一步都要你點頭,借刀就難得多。
公告和事後檢討都沒有公開說明,到底有多少人的本機 AI 工具真的被成功叫起來、做了哪些事。這部分我無法確認,請不要把它讀成「AI 工具被大規模利用」。
防護:四個方向,各自擋什麼
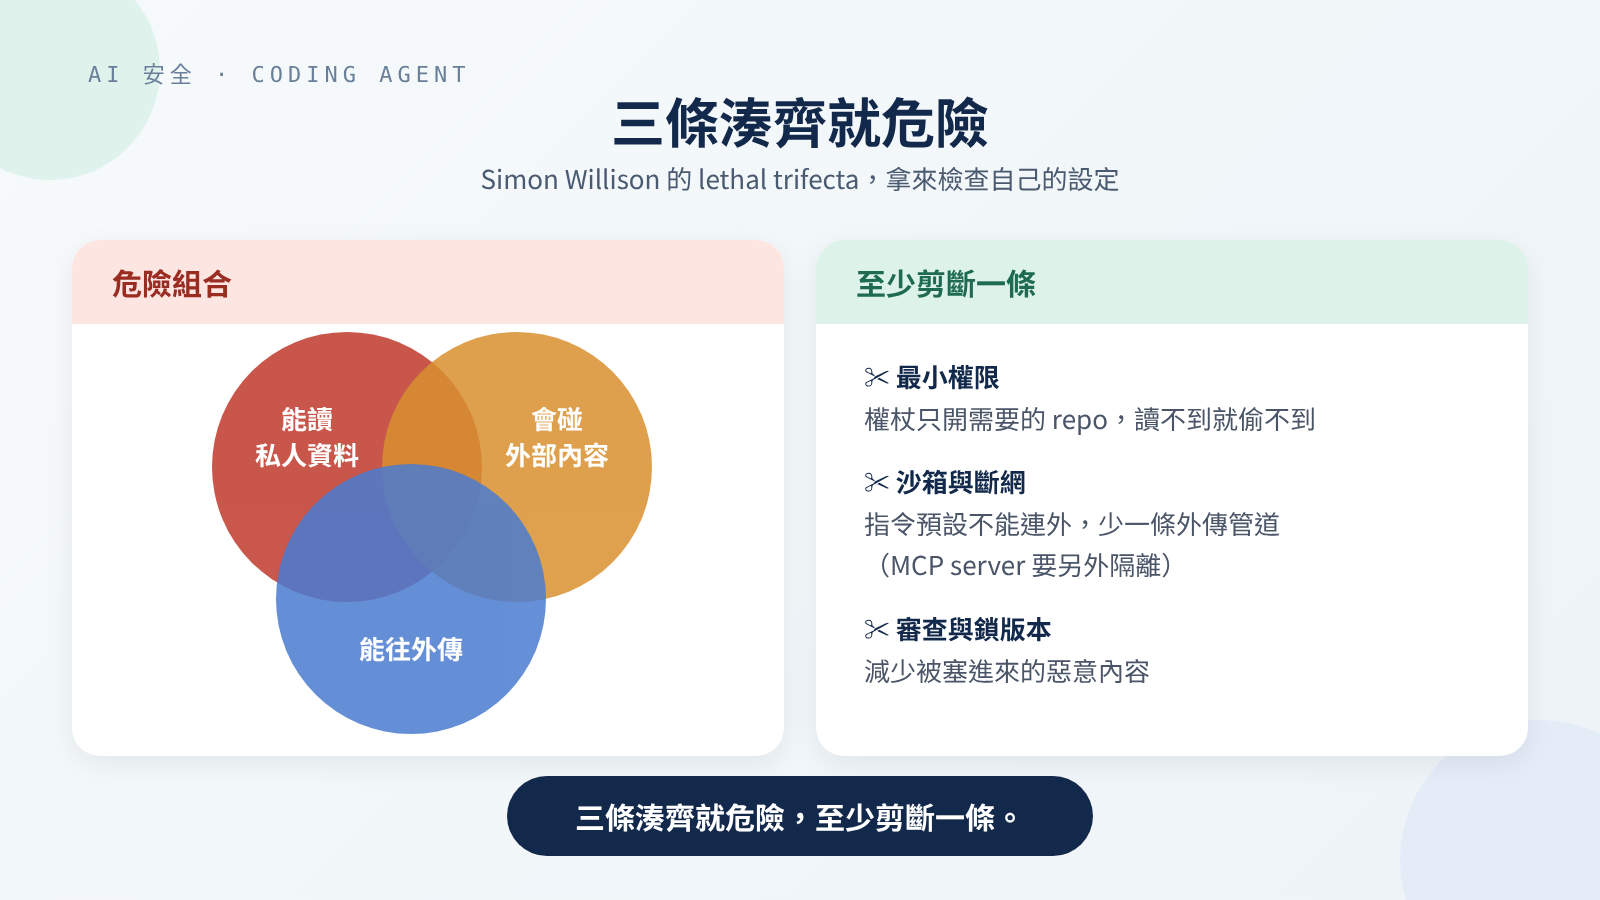 防護的目標不是讓 AI 變聰明,而是讓它就算被騙了也做不了大事。
觀點:沒有任何一招能單獨解決提示注入。目前比較實際的思路,是假設 agent 有一天一定會讀到惡意內容,然後確保那一天它能造成的傷害很小。
1. 最小權限:給它剛好夠用的鑰匙
- GitHub 權杖用細粒度權杖(fine-grained token,只開特定 repo 和特定權限的通行碼,在 GitHub 的 Settings → Developer settings → Personal access tokens → Fine-grained tokens 建立);不要直接把
gh的完整登入狀態給 agent。 - 一個工作階段只碰一個專案。Invariant 在案例 2 的建議之一,就是限制 agent 每個工作階段只能操作一個 repo(他們是用自家的 Guardrails 工具示範,概念可以用其他方式實作)。
- MCP 授權範圍從最小開始,需要時再加。這是 MCP 安全最佳實務的「範圍最小化」。
- 把憑證移出明文檔案。Nx 的事後檢討也建議避免把權杖和 API key 明文放在設定檔裡。
2. 沙箱:讓它在圍欄裡跑
事實:
- Codex CLI 預設用作業系統層級的沙箱,預設不開網路、只能寫目前的工作區;在可寫範圍內,
.git、.codex、.agents這些資料夾仍是唯讀。 - Claude Code 提供可設定檔案與網路隔離的沙箱 Bash,也建議處理不可信內容時用虛擬機或 dev container(把整個開發環境裝進一個隔離容器)。
事實:沙箱有邊界。Codex 文件寫明,它的指令網路代理不會過濾 MCP server 的連線、網頁搜尋或連接器呼叫;在 dev container 裡用完全存取模式,惡意專案仍然能偷走容器內的一切,包括 Codex 的憑證。
推論:沙箱擋的是「agent 跑的指令」,不一定擋得到「MCP server 自己做的事」。本機 MCP server 是另一支程式,要另外隔離。
3. 審查:裝之前看一遍,裝之後看變化
- Skill 要看整個資料夾,不只
SKILL.md。Anthropic 文件列出的重點包括:腳本、圖片和其他資源都要看,留意意料之外的網路請求、檔案存取,以及會去抓外部網址的 skill。 - MCP server 要看它會被怎麼啟動:完整的指令和參數。MCP 規範要求一鍵設定時必須顯示完整、未截斷的執行指令。
- 專案裡的
.mcp.json、.cursor/mcp.json、.claude/和 skill 資料夾,都當成程式碼審 PR。Claude Code 文件也提醒,只看.mcp.json看不到所有會被載入的伺服器,外掛和其他層級的設定也會加伺服器。
4. 鎖版本:不讓它在你背後換掉
- Skill 從固定的 commit 安裝,而不是追最新的 main。
- MCP server 常用
npx或uvx(「下載並直接執行某個套件」的指令)啟動。啟動時寫死版本號,不要用@latest(永遠抓最新版)或乾脆不寫版本。Nx 事件裡,正是「自動裝最新版」讓沒用 Nx 的人也中招。
具體寫法像這樣(<commit> 換成你審過的那個 commit):
1
2
3
4
5
6
# MCP:寫死你審過的版本號(至少要 0.1.16 以上,才包含 CVE-2025-6514 的修補),不要寫 npx mcp-remote 或 @latest
npx -y mcp-remote@<你審過的版本號> https://mcp.example.com/mcp

# Skill:先 clone,再切到審過的 commit
git clone https://github.com/someone/some-skill.git
git -C some-skill checkout <commit>
- Invariant 也建議把 MCP server 和工具說明鎖住,用雜湊值檢查有沒有被改,防的就是案例 1 的「翻臉」。
觀點:鎖版本在 agent 世界裡比在一般專案更重要。一般套件被換掉,你的測試可能會壞;skill 的說明被換掉,什麼都不會壞,AI 只是開始做別的事。
檢查清單
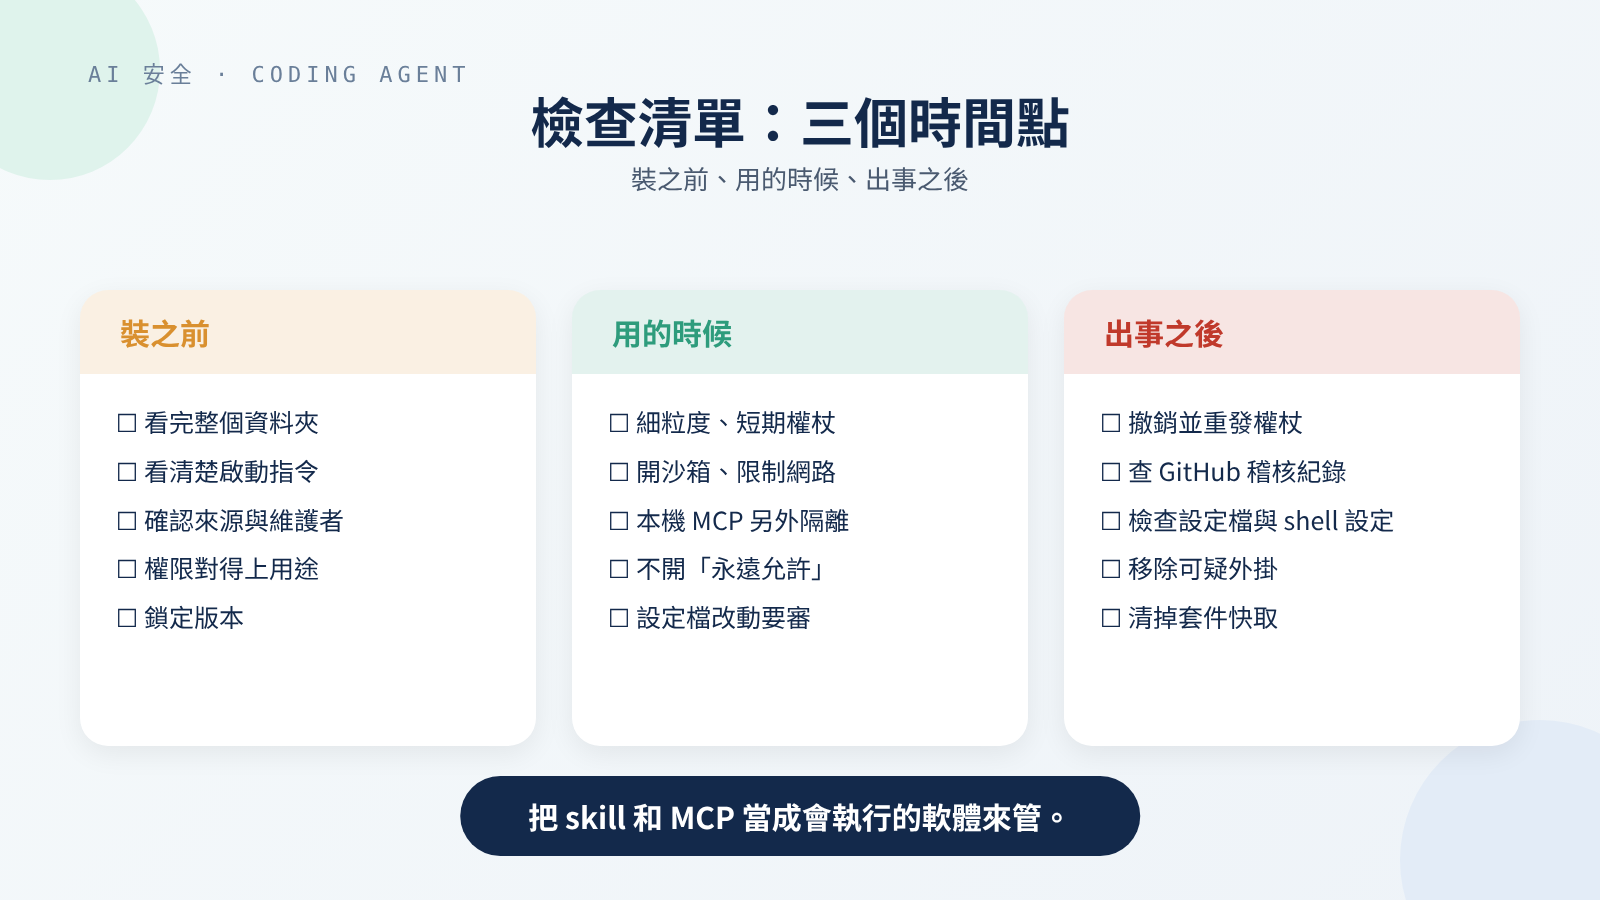 清單分三段,各自對應不同的時間點。
裝之前
- 來源是誰?是自己、公司內部,還是有在維護、有公開問題回報管道的專案?
- Skill:整個資料夾都看過了嗎?有沒有腳本、會不會連外、會不會讀家目錄?
- MCP:完整的啟動指令和參數是什麼?它會拿到哪些環境變數?
- 它要求的權限,跟它宣稱的用途對得上嗎?
- 版本有沒有鎖在特定 commit 或版本號?
- 這個新工具裝上去後,lethal trifecta 三條會不會因此湊齊?
用的時候
- Agent 用的權杖是不是細粒度、短期、只開需要的範圍?
- 沙箱有開嗎?網路是預設關閉,還是只放行特定網域?
- 本機 MCP server 有沒有另外隔離(容器、獨立使用者)?
- 有沒有對「寫設定檔」「發 PR」「推送」這類動作保留人工確認?
- 讀不可信內容(陌生 repo 的 issue、外部網頁)的工作,是不是跟持有私人資料的工作分開跑?
- 專案的 agent 設定檔改動,是不是有經過 code review?
出事之後(或懷疑出事時)
- 撤銷並重發 agent 能碰到的所有權杖:GitHub、npm、雲端、MCP 連線密碼。
- 查 GitHub 稽核紀錄,看有沒有不認得的 repo、PR、推送。Nx 公告就是請使用者到安全紀錄查有沒有新建 repo。
- 檢查
.mcp.json、.cursor/mcp.json、skill 資料夾、~/.bashrc、~/.zshrc(每次開終端機都會自動執行的設定檔)有沒有被加料。 - 移除可疑的 skill 和 MCP server,清掉
npx等套件快取。
結論
裝第三方 skill 和 MCP,本質上就是在 agent 身邊多放了別人的程式和別人的文字。前者帶來一般的供應鏈風險,後者帶來 AI 特有的提示注入風險,而 agent 手上的權限決定了兩者能造成多大的傷害。
觀點:我認為最值得先做的,不是找一個號稱能擋下 95% 攻擊的防護產品(Willison 對這類宣稱也很懷疑,他的說法是:在 Web 安全裡,95% 是不及格的分數),而是兩件很無聊的事:把 agent 的權杖縮到最小,以及鎖住你裝的每一個 skill 和 MCP 的版本。前者限制「被騙之後能做什麼」,後者減少「在你不知情時被換掉」。
這和我之前寫的 HEIF 圖片與 SSO 攻擊鏈其實是同一個教訓:一個看起來很小的入口,真正的損害取決於它背後連著多少信任。
來源
官方文件
- Anthropic,Agent Skills overview:Security considerations
- Anthropic,Claude Code Security
- OpenAI,Codex:Agent approvals & security
- Model Context Protocol,Security Best Practices(2025-06-18 版)
公告與 CVE
- GitHub,GHSA-6xpm-ggf7-wc3p(mcp-remote,0.1.16 修補)
- Cursor,GHSA-4cxx-hrm3-49rm;CVE-2025-54135
- CVE-2025-6514(mcp-remote);JFrog,研究報告;修補 commit
- Nx,GHSA-cxm3-wv7p-598c;S1ngularity 事後檢討
研究報告與觀點
- Invariant Labs,MCP Security Notification: Tool Poisoning Attacks(2025-04-01)
- Invariant Labs,GitHub MCP Exploited: Accessing private repositories via MCP(2025-05-26)
- Simon Willison,The lethal trifecta for AI agents(2025-06-16)