Jekyll 多语言博客:用 polyglot 维护繁简英三版
本站每篇文章都有繁中、简中、英文三个版本。这篇用实际的配置说明网址怎么分、译文怎么放、插件没处理到的网址怎么补,以及怎么让搜索引擎分清三个版本。
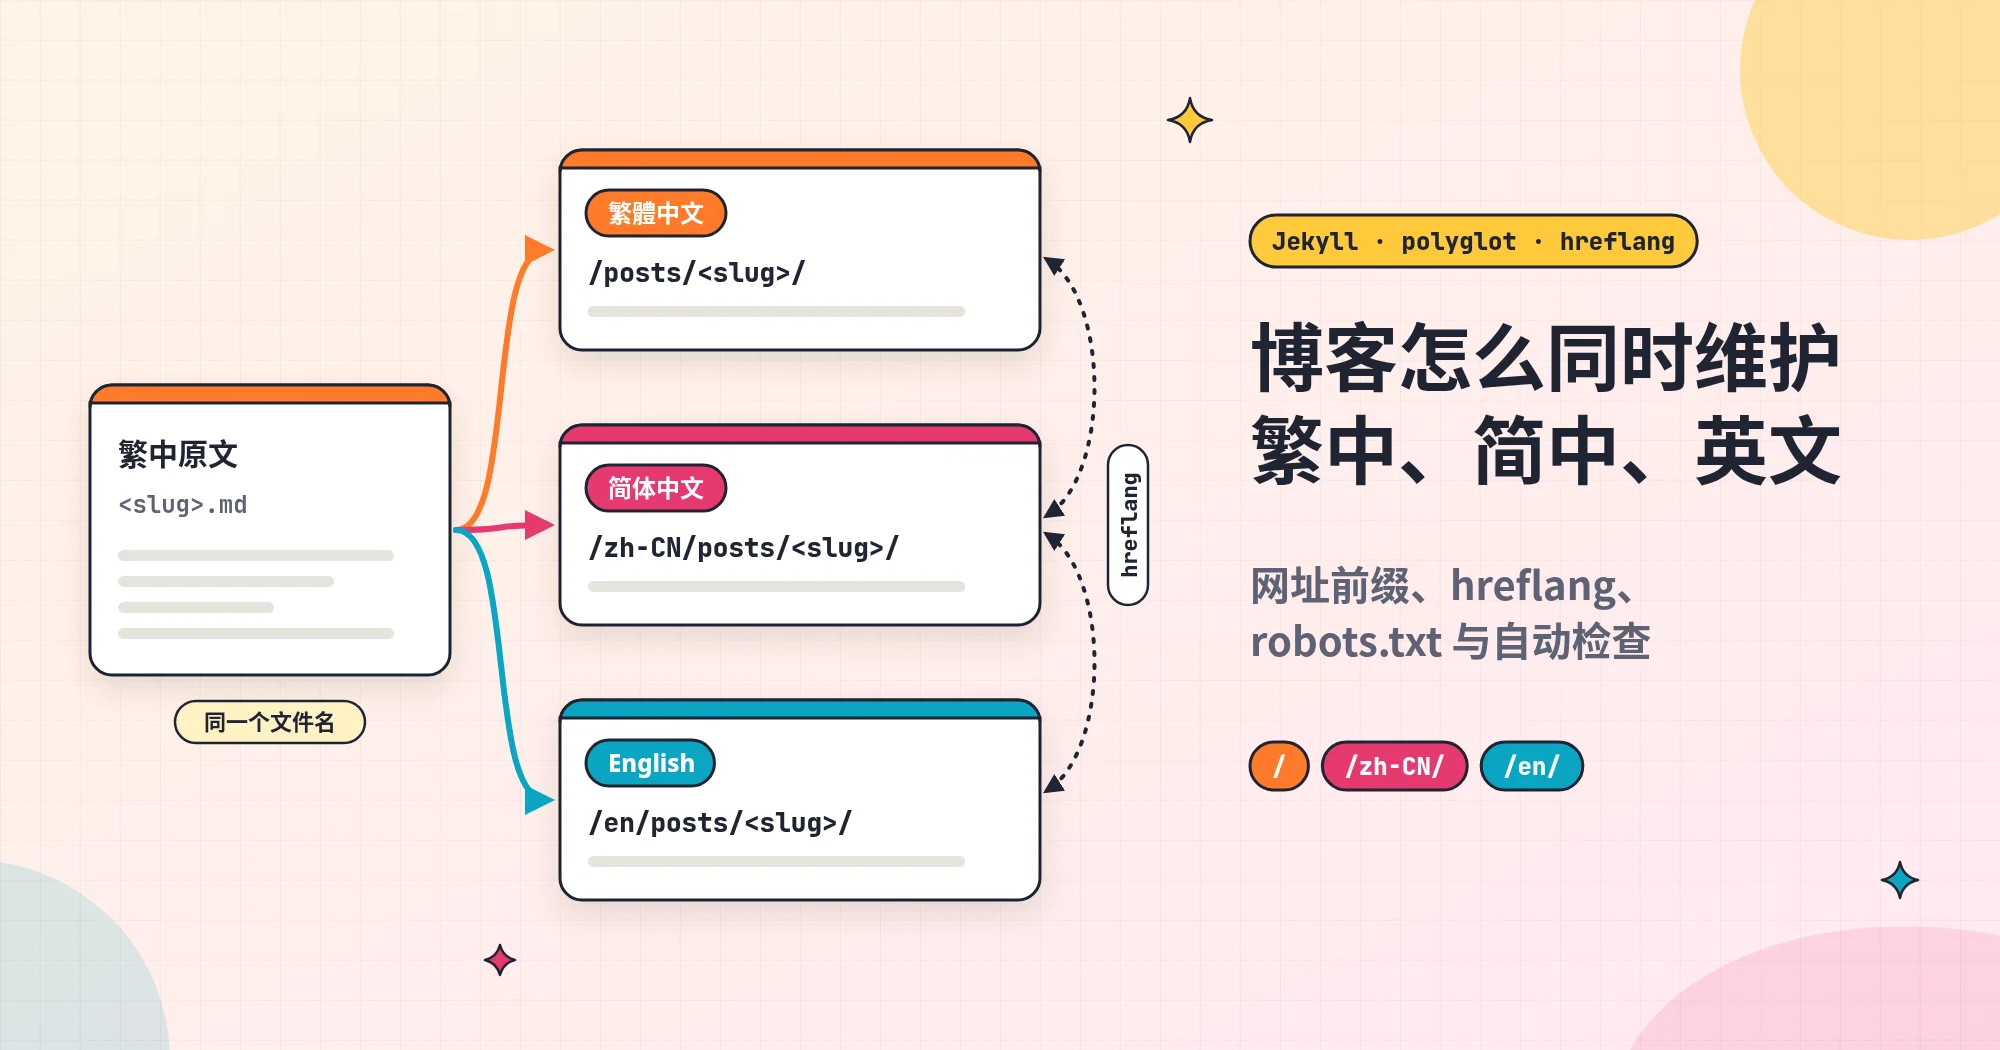
这个网站从 2026 年 9 月底开始,每篇文章都同时有繁体中文、简体中文、英文三个版本。我写这篇的时候,三个语言各有 28 篇(不算这篇),一篇不缺。我想做三语,是因为读者不只在台湾。
动手后才发现,“把文章翻成三份”只是最容易的一段。麻烦的是那些看不到的地方:分享出去的链接指向哪个语言、搜索引擎知不知道这三页是同一篇、读者从 Google 点进来会不会被带走。这些地方做错了,网站照样能打开,只是悄悄出错。
这篇用本站实际的配置,说明我怎么处理这些事,想给自己的个人网站加上多语言的人可以拿它当参考。本站用 Jekyll 和 Chirpy 主题;换成别的工具,做法会不同,但要处理的问题大多一样。
版本说明:本文依据 2026-11-13(台北时间)当天本站 repo 的配置。当时使用的是 Jekyll 4.4.1、Chirpy 主题 7.6.0、jekyll-polyglot 1.14.0。Google 与 polyglot 的说法,参考的是同一天的官方文档。整个站的配置都公开在 GitHub repo,除了
CLAUDE.md,文中提到的文件都能在那里看到完整内容。
开始前:先认识几个词
- Jekyll:把 Markdown 文章转成网页的工具。它在发布前一次生成所有网页(这种网站叫静态网站),服务器只负责把文件发出去。
- 主题(theme):决定网站外观和布局的一整套文件。本站用 Chirpy。
- front matter:每篇文章最上面、夹在两行
---之间的配置,写标题、日期、分类等信息。 - permalink:一篇文章固定的网址路径,例如
/posts/jekyll-blog-three-languages/。 - 插件(plugin)与 hook:插件是给 Jekyll 增加功能的程序。hook 是 Jekyll 在构建的某个时间点(例如“网页都生成完之后”)自动调用的一段代码。
- GitHub Actions:GitHub 提供的自动化服务。本站每次合并新的修改,它就会自动构建网站并发布到 GitHub Pages。
- sitemap:列出网站所有网址的文件,给搜索引擎看。
- hreflang:写在网页里、告诉搜索引擎“这一页还有哪些语言版本、网址在哪”的标记。
网址怎么分:繁中在根目录,其他语言加前缀
三个语言的网址长这样:
| 语言 | 首页 | 这篇文章 |
|---|---|---|
| 繁体中文(默认) | / | /posts/jekyll-blog-three-languages/ |
| 简体中文 | /zh-CN/ | /zh-CN/posts/jekyll-blog-three-languages/ |
| 英文 | /en/ | /en/posts/jekyll-blog-three-languages/ |
繁中是我写作的语言,所以放在根目录,其他语言在网址前面加上语言代码。这是 jekyll-polyglot(以下简称 polyglot)这个插件的做法,配置只有几行,写在 _config.yml。以下是节选,exclude_from_localization 实际列了更多文件:
1
2
3
4
5
6
7
8
9
10
11
languages: ["zh-TW", "zh-CN", "en"]
default_lang: zh-TW
lang_vars: [lang]

# 这些文件只输出一份在根目录,不复制到 /<lang>/ 之下
exclude_from_localization:
  - assets/lib
  - assets/img
  - assets/js/i18n.js
  - assets/robots.txt
  - CNAME
polyglot 的原理是每个语言各构建一次完整的网站,它的 README 写道,它会“为每个要处理的语言各开一个独立的进程”。默认语言输出到根目录,其他语言输出到 /zh-CN/、/en/ 下面。每次构建时,网站的语言变量会换成那个语言。
Chirpy 主题本来就有繁中、简中、英文的界面文字。语言变量一换,“上一篇”、“分类”、“搜索”这些按钮文字就自动换成对应语言,我不必自己翻。
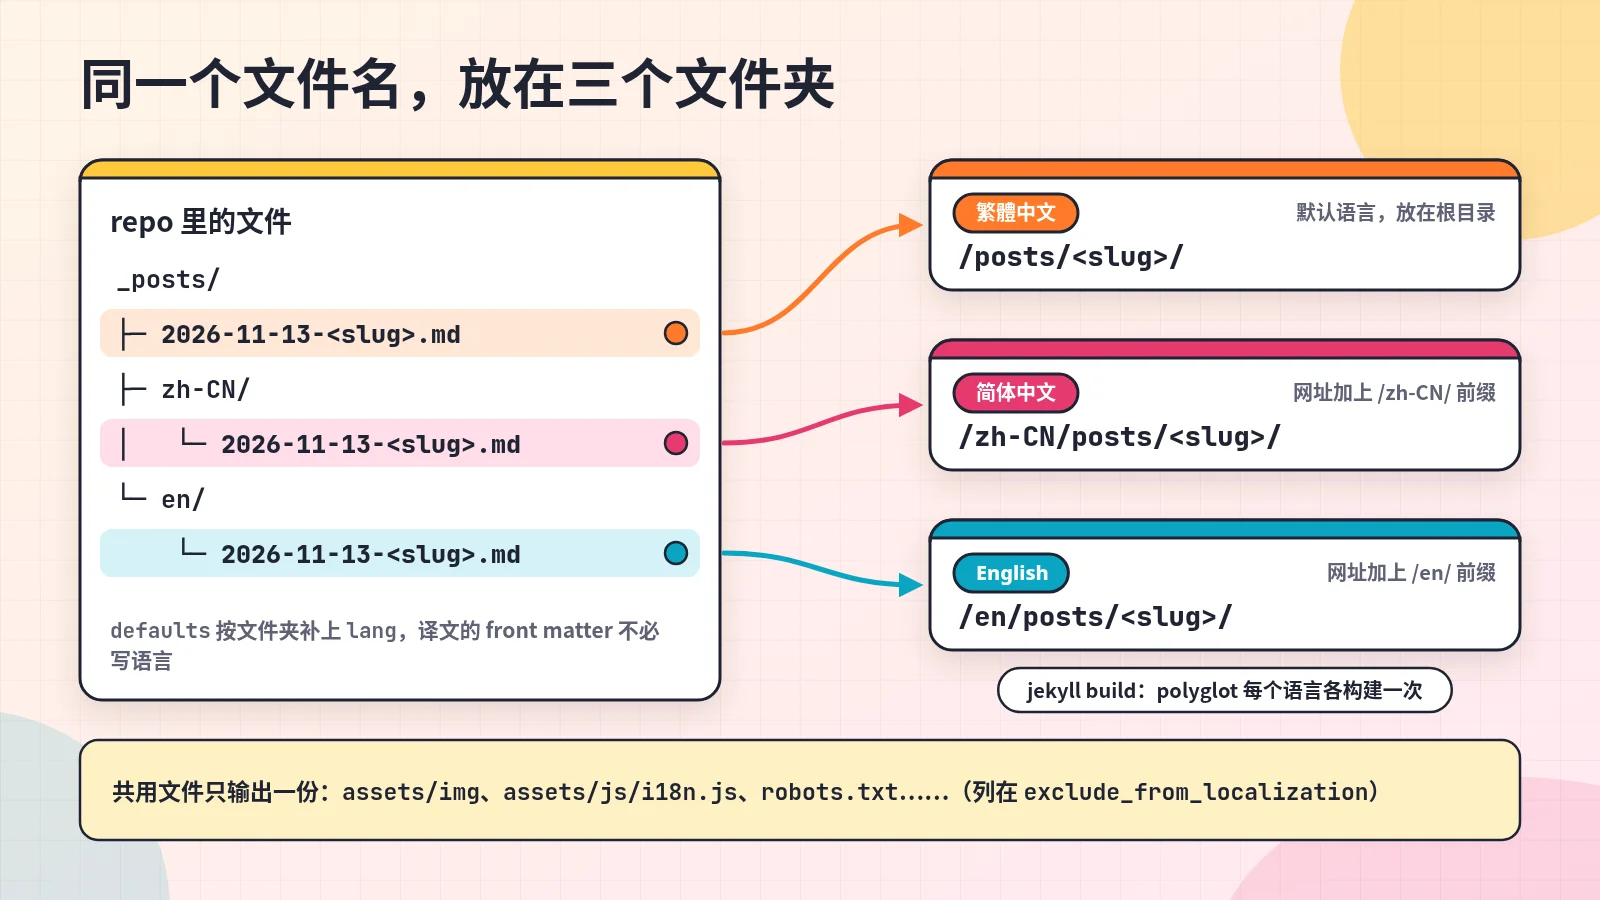
exclude_from_localization 列的是三个语言共用、只需要一份的文件,例如图片和 JavaScript。不列进去的话,每张图片都会被复制三份。
译文怎么放:同一个文件名,放在三个文件夹
一篇文章的三个版本,文件名完全相同,只是放在不同文件夹:
1
2
3
4
5
6
_posts/
├── 2026-11-13-jekyll-blog-three-languages.md        ← 繁中原文
├── zh-CN/
│   └── 2026-11-13-jekyll-blog-three-languages.md    ← 简中
└── en/
    └── 2026-11-13-jekyll-blog-three-languages.md    ← 英文
译文的 front matter 不必写语言,_config.yml 的 defaults 会按文件夹自动补上:
1
2
3
4
5
6
7
8
9
defaults:
  - scope:
      path: _posts/zh-CN
    values:
      lang: zh-CN
  - scope:
      path: _posts/en
    values:
      lang: en
polyglot 看到三份文件的 permalink 相同,就把它们当成同一篇的不同语言版本。
某个语言缺了译文时,polyglot 会拿繁中原文顶替;README 的说法是,缺少对应版本的页面会“退回 default_lang”,内容不会消失。这个机制让我可以先发繁中、晚点再补译文,不过本站的规则是三个版本一起发布,所以实际上没用到。
侧栏的“关于”、“项目”这类有正文的页面也一样,译文放在 _tabs/zh-CN/、_tabs/en/。
翻译规则写在 repo 里
三个版本要一致,靠的不是记性,而是写下来的规则。我把规则写在 repo 的 docs/translation-guide.md。
这份文档整理自 CLAUDE.md,也就是给 AI 助手读的项目说明;CLAUDE.md 本身列在 .gitignore 里,没有放到 GitHub 上。不论是我自己翻,还是请 AI 起草,都照同一份规则(给 AI 看的规则文件怎么写,可以参考AGENTS.md 怎么写:让 Coding Agent 读懂你的项目规则):
- 简中不是转换字形就好,用词要换成大陆惯用的说法,例如“軟體”改成“软件”、“程式碼”改成“代码”,引号「」改成“”。同一个词要看上下文,例如“指令”只有在指命令行时才改成“命令”。
- 三个版本的
tags必须完全相同,因为各语言共用同名的标签页。 categories按一张固定的对照表翻译,例如“資訊安全”在简中是“信息安全”,在英文是“Security”。新增分类时,我就在表上补一行。- 站内链接我一律写成
/posts/<slug>/,不写语言前缀,构建时会自动补上。
最后一条很重要。如果我在英文文章里手写 /en/posts/...,看起来没错,但哪天网址规则改了,我就得一篇一篇找出来修改。
polyglot 没处理到的网址:自己写 hook 补
polyglot 会把 HTML 里 href="..." 形式的站内链接补上语言前缀,所以英文页面上的链接会连到其他英文页面。问题是,网页里还有很多网址不是写在 href 里,它们仍然指向繁中版:
og:url:分享到社交平台时,卡片上链接过去的网址。- JSON-LD:写给搜索引擎看的结构化数据,里面有本页网址和作者“关于”页的网址。
- 分享按钮:网址被编码后放在链接的参数里。
- 站内搜索读取的
search.json:路径和里面每篇文章的网址。 - RSS feed 和 sitemap 里的完整网址。
这些不修的话,读者在英文文章点“分享”,朋友打开却看到繁中版;搜索引擎读英文页的结构化数据,看到的本页网址却是繁中那一页。网站看起来一切正常,所以很难发现。
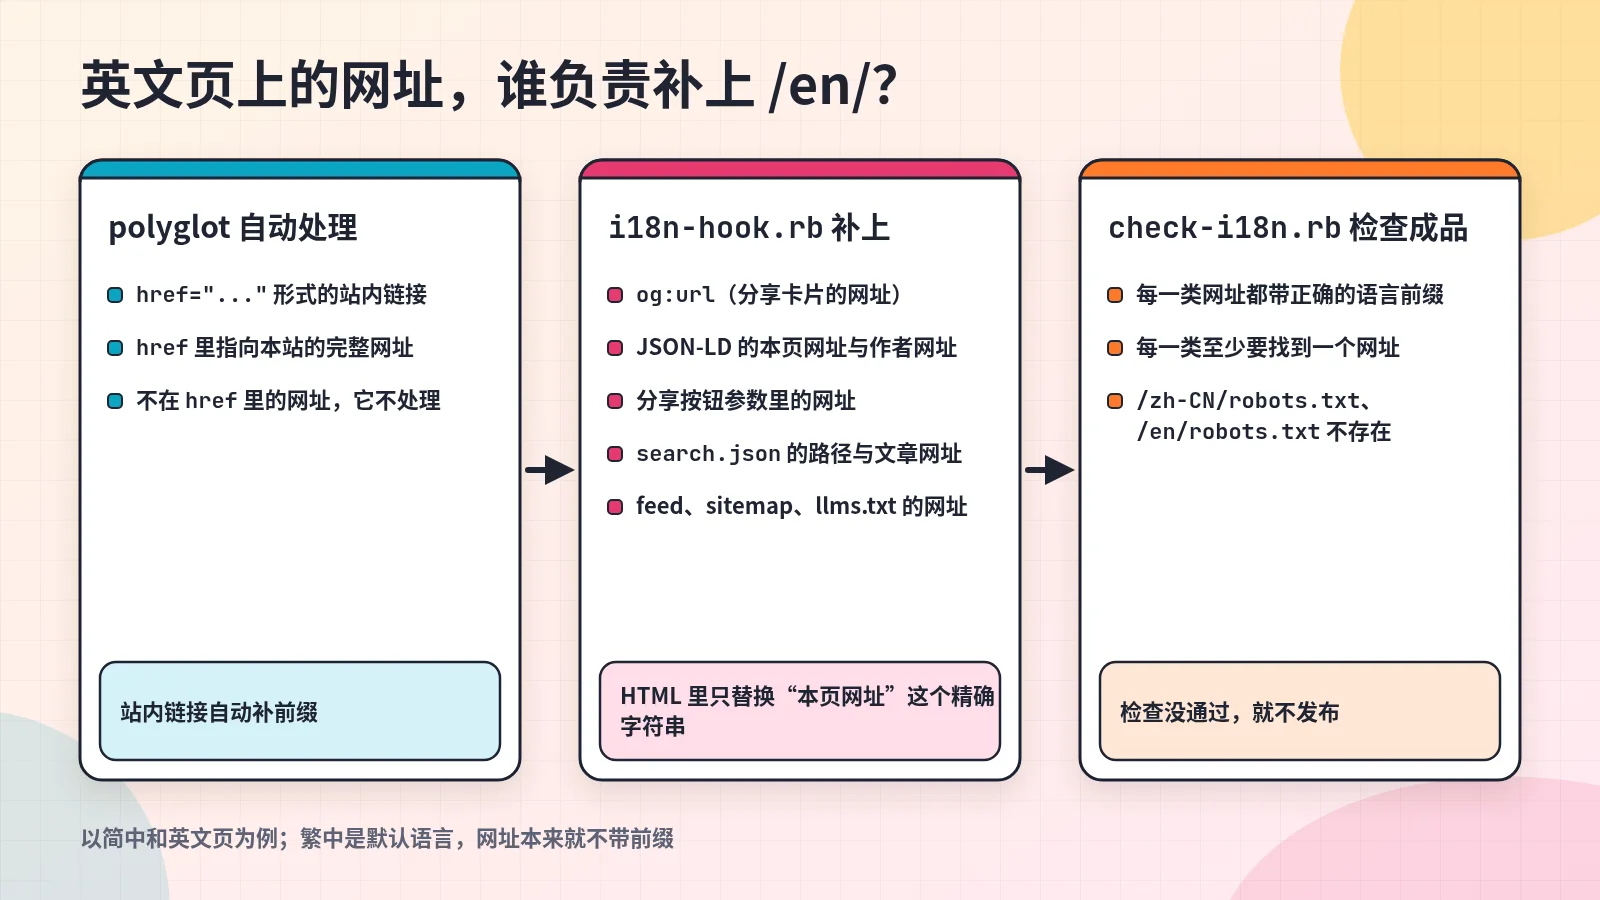
我写了一个 hook 补上这些网址,文件是 _plugins/i18n-hook.rb。它在 polyglot 处理完之后执行,把“本页的繁中网址”这个精确字符串换成该语言的网址。下面是处理 HTML 的核心部分:
1
2
3
4
5
6
7
page_url = "#{ origin }#{ doc.url }"
local_url = "#{ origin }/#{ lang }#{ doc.url }"
doc.output = doc.output
  .gsub(%(content="#{ page_url }"), %(content="#{ local_url }"))
  .gsub(%("url":"#{ page_url }"), %("url":"#{ local_url }"))
  .gsub(%("@id":"#{ page_url }"), %("@id":"#{ local_url }"))
  .gsub(CGI.escape(page_url), CGI.escape(local_url)) # 分享按钮的 query string
只换精确字符串,是为了不误改其他网址,例如图片的网址(图片只有一份,不该加前缀)和指向繁中版的 hreflang 链接。
同一个 hook 也为各语言换掉网站名称和描述。_config.yml 里有一段 i18n_site,写英文版的网站标题、简中版的副标题等,构建该语言时套用。
让搜索引擎分清三个版本
对搜索引擎来说,三个语言就是三个不同的网址。如果什么都不说,它可能把三页当成重复内容,或在用户搜索中文时显示英文版。下面是本站跟多语言直接相关的几项 SEO 配置。
每一页都列出三个语言版本
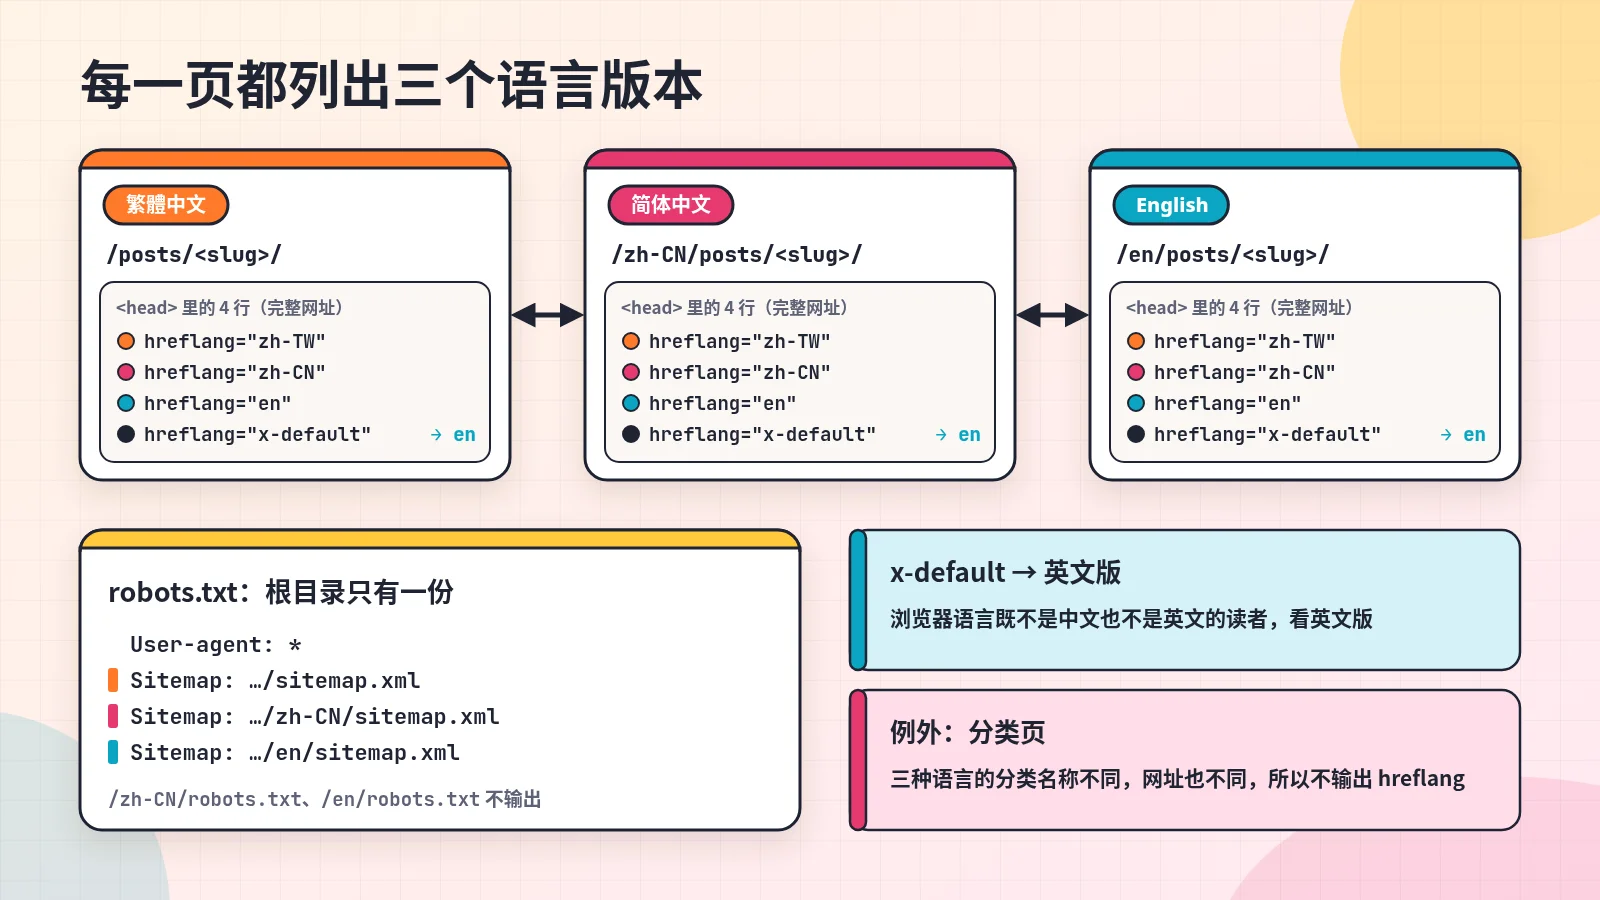
Google 用 hreflang 判断一页的其他语言版本。Google 的说明有几条规则要注意:
- 每个语言版本都要列出自己,以及所有其他语言版本。
- 两页要互相指向对方,只有单向指向的标记会被忽略。
- 网址要写完整,包含
https://。
本站在每一页的 <head> 输出四行,三个语言各一行,再加一行 x-default:
1
2
3
4
<link rel="alternate" hreflang="zh-TW" href="https://justmao.com/posts/jekyll-blog-three-languages/">
<link rel="alternate" hreflang="zh-CN" href="https://justmao.com/zh-CN/posts/jekyll-blog-three-languages/">
<link rel="alternate" hreflang="en" href="https://justmao.com/en/posts/jekyll-blog-three-languages/">
<link rel="alternate" hreflang="x-default" href="https://justmao.com/en/posts/jekyll-blog-three-languages/">
因为三个语言的页面都用同一个模板生成,每一页输出的四行都一样,自然满足“列出自己”和“互相指向”这两条。模板在 _includes/metadata-hook.html,那是 Chirpy 预留给用户在 <head> 加东西的位置。
x-default 的用途,Google 的说法是“没有其他语言符合用户的浏览器设置时使用”。我让它指向英文版,因为浏览器语言既不是中文也不是英文的读者,英文版最可能看得懂。
有一种页面例外:分类页。分类名称在三个语言里不同,例如“資訊安全”、“信息安全”、“Security”,网址也就不同,没有一对一的对应版本,所以分类页不输出 hreflang。
robots.txt 只有一份,列出三份 sitemap
每个语言各自生成一份 sitemap:/sitemap.xml、/zh-CN/sitemap.xml、/en/sitemap.xml。搜索引擎只读域名根目录的 robots.txt,所以我让这一份列出三份 sitemap:
1
2
3
4
5
6
7
User-agent: *

Disallow: /norobots/

Sitemap: https://justmao.com/sitemap.xml
Sitemap: https://justmao.com/zh-CN/sitemap.xml
Sitemap: https://justmao.com/en/sitemap.xml
这里有一个小陷阱。生成 sitemap 的插件 jekyll-sitemap 发现某个语言没有 robots.txt 时,会自动补一份。结果 /zh-CN/robots.txt、/en/robots.txt 又冒出来了。
这两份没有作用,只会让人困惑,所以我让 i18n-hook.rb 等 sitemap 生成完,再把它们从输出列表里去掉,不写成文件。
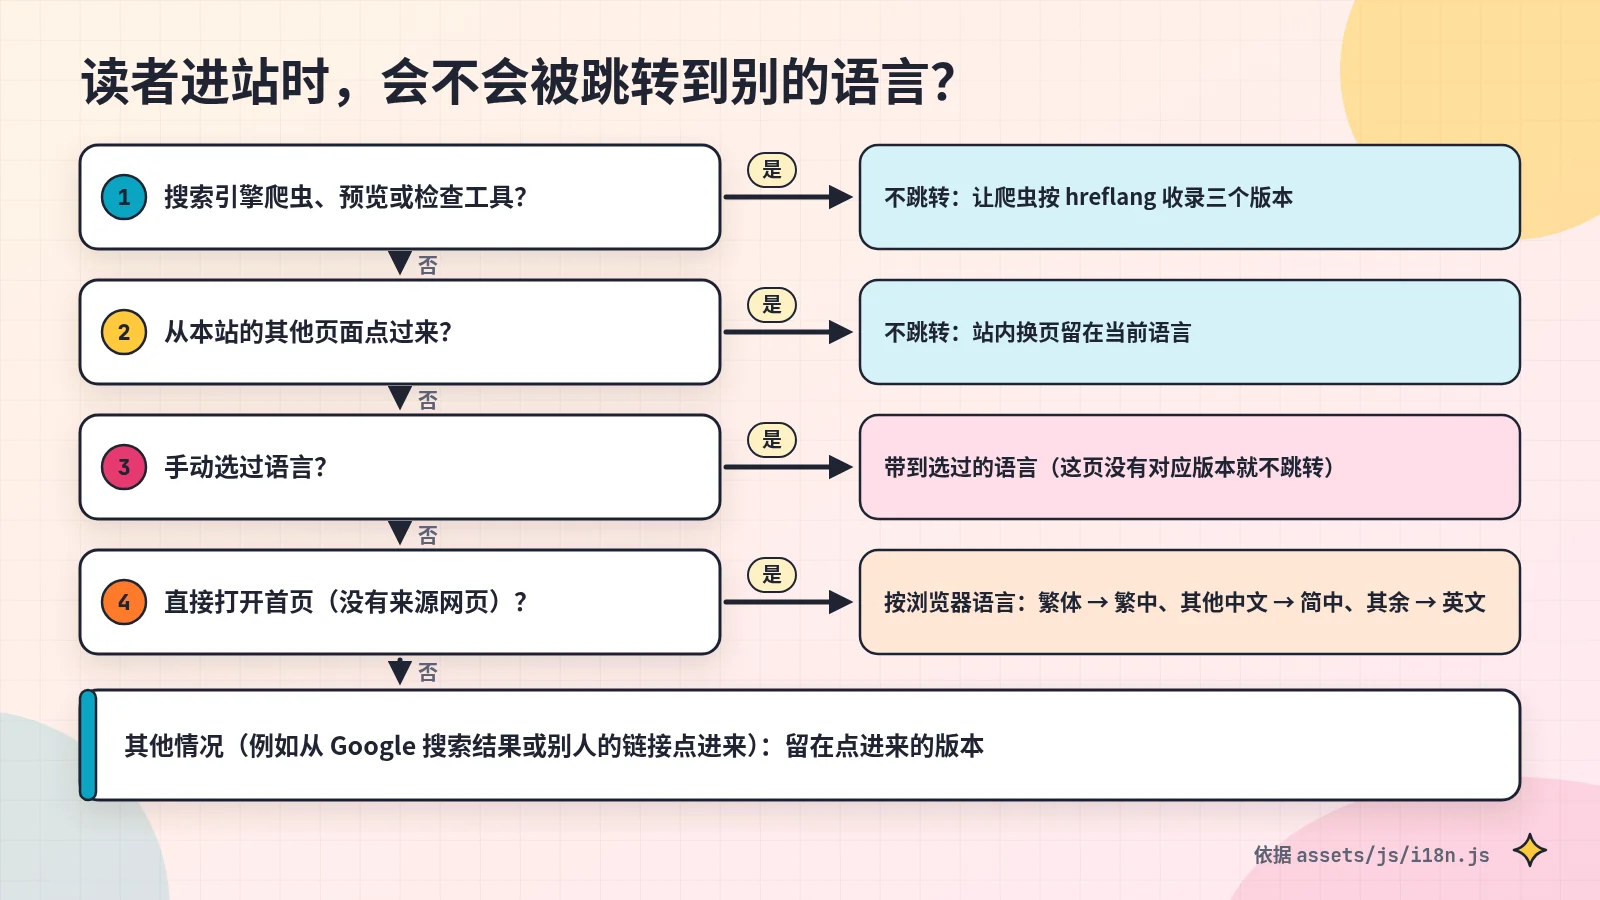
读者进站时,看到哪个语言
多语言网站常见的做法是看浏览器语言,自动把读者跳转到对应版本。Google 的说明建议避免这样做,理由是这种跳转可能让用户和搜索引擎看不到网站的所有版本。它建议的做法是在页面上放其他语言版本的链接,让用户自己选。
本站的规则写在 assets/js/i18n.js,大致是这样:
- 顶栏搜索框旁边有语言菜单,读者选了之后,网站会记住这个选择。
- 读者手动选过语言,之后从站外进来,就带到他选的语言。这是读者自己表达过的意愿,不是网站猜的。如果这一页没有那个语言的版本(例如分类页),就留在原页。
- 没选过的读者,只有在直接打开首页(没有从别的网页点进来)时,才按浏览器语言跳转:繁体中文(含台湾、香港、澳门的设置)到繁中,其他中文到简中,其余语言都到英文。
- 没选过语言、从 Google 搜索结果或别人的链接点进来的读者,留在他点的那个版本,不跳走。
- 搜索引擎的爬虫完全不跳转,让它们按 hreflang 各自收录三个版本。
上面的跳转规则只在从站外进来时才会用到。在站内换页一律不跳转,所以读者点了其他语言的链接,就会留在那个语言。
第 5 条的爬虫名单有一个容易漏掉的项目:Google Search Console 检查网址用的 Google-InspectionTool。它的 User-Agent(浏览器或爬虫发出的自我介绍字符串)里没有 bot 这个词。
我一开始只用 bot、crawl 这类字眼识别爬虫,所以程序没认出它。漏掉的话,它检查英文页时可能被当成普通读者跳转到别的语言,检查的就不是你想看的那一页。
顺带一提:给 AI 工具读的 llms.txt
本站根目录有一份 llms.txt,是给 AI 浏览器和 coding agent 读的文章索引(格式见 llmstxt.org),从文章列表自动生成。它也是每个语言各一份,里面的网址同样由 i18n-hook.rb 补上语言前缀。它跟语言无关的部分,以及其他一般的 SEO 配置,不在这篇的范围内。
用检查挡住“悄悄坏掉”
i18n-hook.rb 靠精确字符串匹配改写网址。这个做法简单,但很脆弱:哪天 Chirpy 主题或 jekyll-seo-tag 改了输出格式,例如在 "url": 后面多加一个空格,匹配就对不上,网址也就没被替换。构建不会报错,网站也照样能打开。
所以我另外写了一个检查程序 tools/check-i18n.rb。它不管 hook 怎么写,只看构建出来的成品:在简中和英文的成品里,上面提到的每一类网址都要带正确的语言前缀,而且每一类都至少要找到一个网址。
“至少找到一个”这条,是防止“格式变了,所以一个都没抓到,所以零个错误”这种假的通过。它也会检查 /zh-CN/robots.txt、/en/robots.txt 不存在。
检查项目写成一张表,新增一类需要带前缀的网址时,我在表上加一行就好。下面的 head[s] 只取网页的 <head> 那一段,因为像这篇文章的代码块里,也会出现同样的字符串:
1
2
3
4
5
checks = [
  ['og:url', html, ->(s) { head[s].scan(/property="og:url" content="([^"]*)"/).flatten }, is_local_page],
  ['JSON-LD @id', html, ->(s) { head[s].scan(/"@id":"([^"]*)"/).flatten }, is_local_page],
  # ……分享按钮、search.json、feed.xml、sitemap.xml、llms.txt
]
这个检查放在 GitHub Actions 的发布流程里。提交 pull request 时也会跑同样的检查,只是不发布:
flowchart TD
  M[合并新的修改] --> B[构建网站]
  R[提交 pull request] --> B
  B --> C[check-i18n.rb]
  C --> S[SEO 检查]
  S --> H[html-proofer 查站内链接]
  H --> Q{全部通过?}
  Q -- 否 --> N[不发布]
  Q -- 是 --> T{由 pull request 触发?}
  T -- 是 --> N
  T -- 否 --> D[发布到 GitHub Pages]
html-proofer 是检查网页链接和图片有没有失效的工具。在本地执行下面这行,就能跑完整套:
1
bash tools/test.sh
代价:每篇写三次,构建与维护也变多
三语实际的代价有这三项:
- 每篇文章要写三次。 就算请 AI 起草,简中的用词和英文的语气我还是要看过。原文修改后,两份译文也要跟着改。
- 构建要做的事变多。 polyglot 每个语言各构建一次完整的网站(默认会同时运行),语言越多,每次构建要做的事就越多。
- 要多维护两个程序。
i18n-hook.rb和check-i18n.rb都是因为 polyglot 没处理到才需要的。升级主题或插件之后,我要重跑检查。
如果你也想做
按我做这个网站的经验,顺序可以这样排:
- 先决定网址规则,哪个语言放根目录、其他语言用什么前缀。之后再改,所有旧网址都要做重定向。
- 把翻译规则写下来,尤其是分类和标签怎么对应。
- 构建后打开非默认语言页面的源代码,搜索你的域名,看每一个网址是不是都带了语言前缀。
og:url、结构化数据、分享按钮和 sitemap 最容易漏掉。 - 每一页输出完整的 hreflang,包含指向自己的那一行。
- 不要按浏览器语言强制跳转,改放一个语言菜单。
- 把第 3 步写成自动检查,放进每次发布都会跑的流程里。
第 3 步是最容易被跳过的。网站看起来正常,不代表每一个网址都对了。