採購法 PDF 題庫變成不靠題序記憶的練習網站
從解析題庫、隨機組卷,並用跨練習統計找出弱項
做這個專案,是因為老婆報名了採購法證照考試。
直接照著 PDF 題庫練習幾次,很容易連題目順序和答案一起記住。下一頁還沒翻,答案已經先浮出來。這種熟悉感無法分辨記住的是題目內容,還是答案在 PDF 裡的位置。
要解的問題是:怎麼把固定題庫改造成每輪順序不同、還能留下弱項的練習?
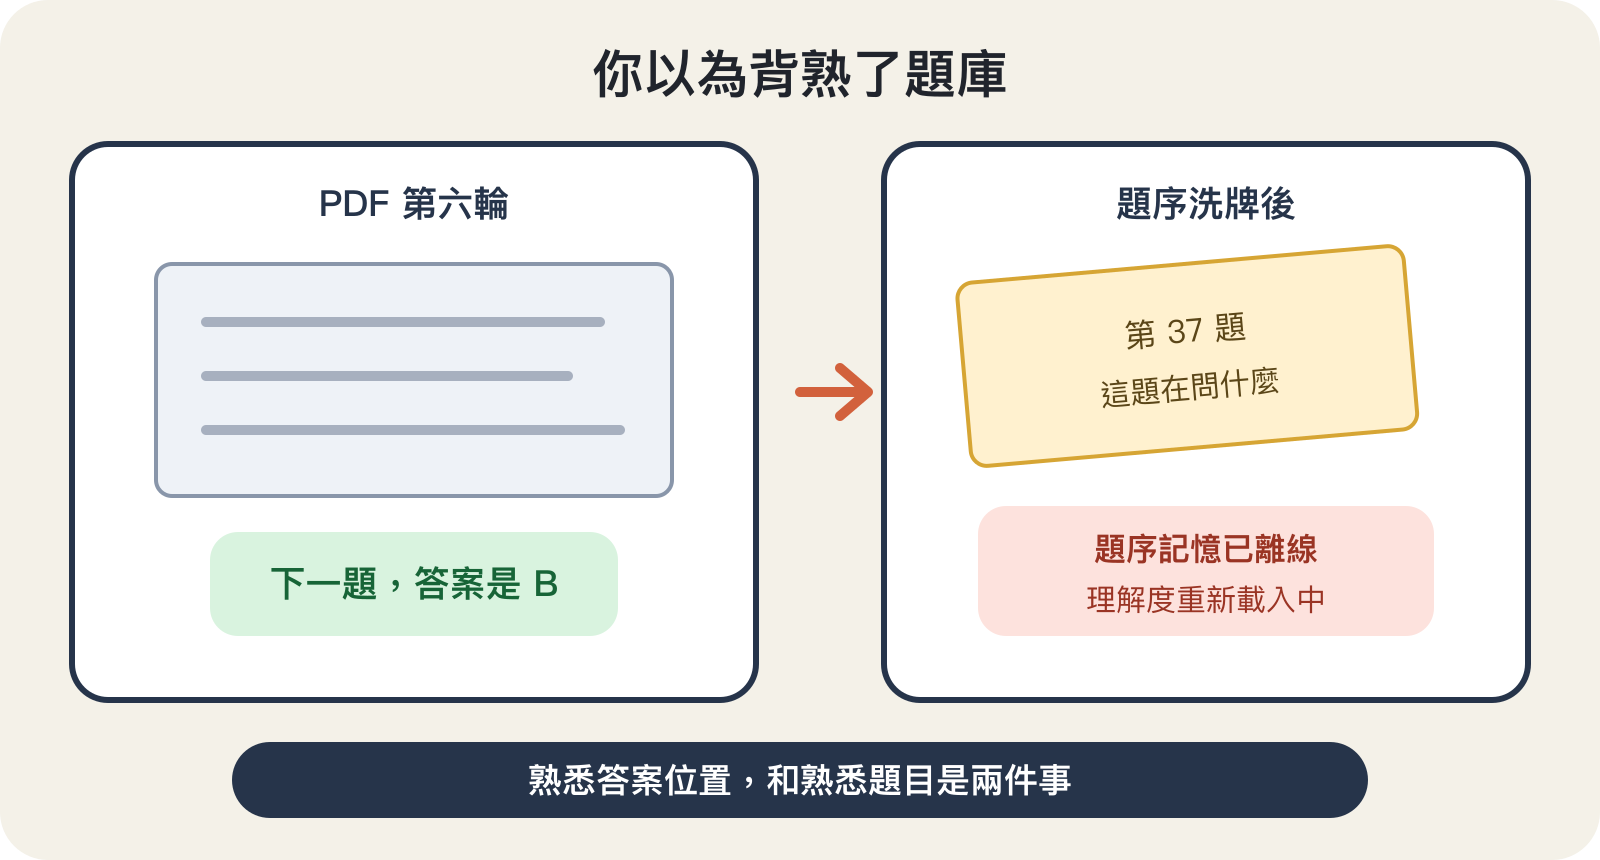 題序一洗牌,熟悉感就不能代替理解。
這是一套把官方題庫變成練習紀錄的 Web App
gpa-question-webapp 是一套政府採購法題庫練習網站。本文檢查的版本是 commit b29fe3f。套件宣告的版本是 0.1.0,需要 Python 3.11 以上,並使用 FastAPI、SQLAlchemy、Jinja2、pdfplumber 與 python-docx。這些資訊都寫在 pyproject.toml。專案採用 MIT License。
它接手已下載到本機的官方 PDF 或 DOCX,透過 parse_command 將題目寫進資料庫。瀏覽器端的路由涵蓋隨機練習、立即對答案、單次成績與跨練習弱項統計,入口集中在 src/api/main.py。
整體架構有兩條資料路徑。上半部把手動下載的官方題庫交給 CLI,解析後寫進 PostgreSQL;下半部由瀏覽器介面呼叫 FastAPI,讀寫題目、session 與作答紀錄。
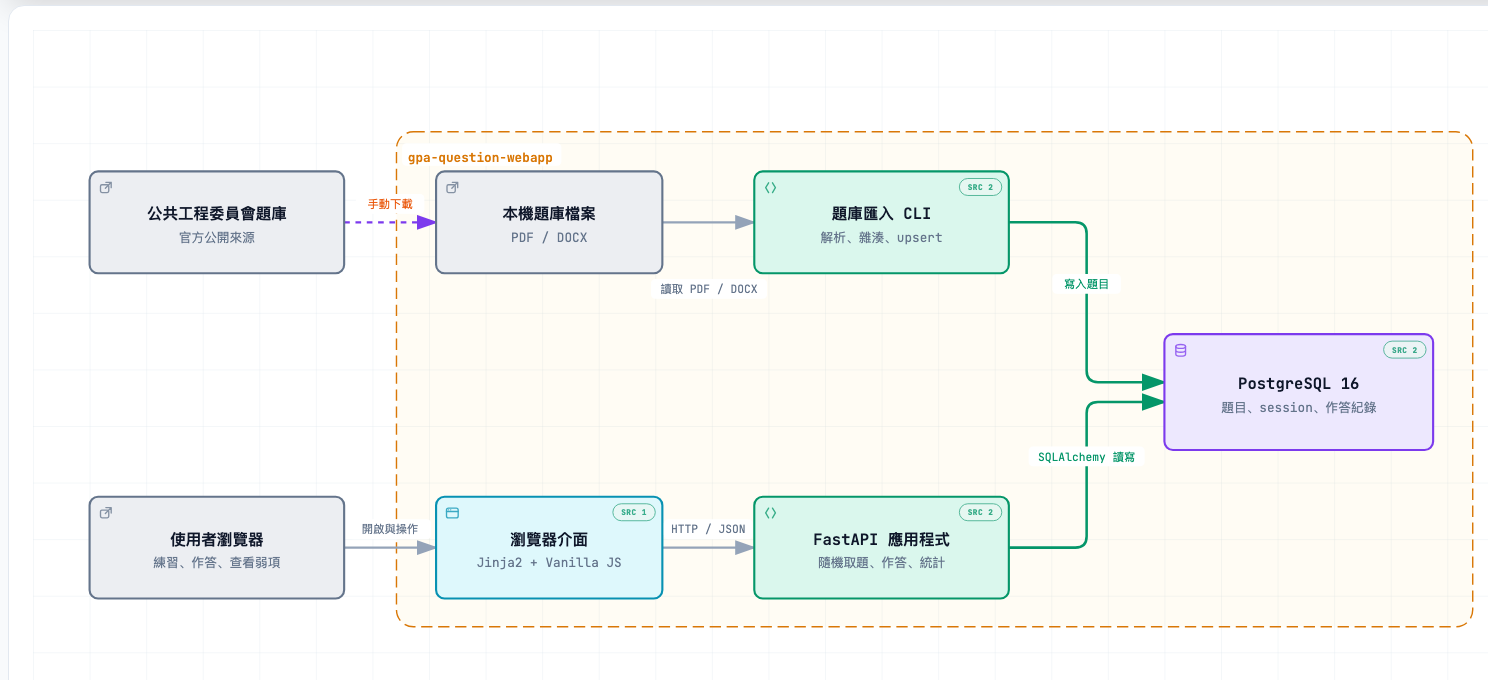 架構圖依據 commit
b29fe3f 繪製;開啟互動版。
資料怎麼從 PDF 走到一道可作答的題目
第一段是匯入。CLI 掃描輸入目錄中的 .pdf 和 .docx,再依副檔名交給對應解析器。若沒有指定類別,檔名開頭的 1 到 13 會被當成類別編號。實作可見 src/ingestion/cli.py。
PDF 解析器先用「是非題」與「選擇題」切段,再用規則運算式辨識題號及答案。選擇題答案 1 到 4 會轉成 A 到 D。實際規則寫在 src/ingestion/pdf_parser.py。
1
2
3
MC_QUESTION_START = re.compile(r"^\s*(\d+)\s+([1-4])\s+(.+)")
TF_QUESTION_START = re.compile(r"^\s*(\d+)\s+([OX])\s+(.+)")
ANSWER_NUM_TO_LETTER = {"1": "A", "2": "B", "3": "C", "4": "D"}
第二段是去重與更新。每題的 source_hash 由類別、題型和題目文字串接後計算 SHA-256。再次匯入時,相同雜湊會更新答案、選項或法規出處;來源裡消失的題目則標上 deleted_at。完整流程在 src/ingestion/base.py。
1
2
3
4
@property
def source_hash(self) -> str:
    raw = f"{self.category_id}|{self.question_type}|{self.question_text}"
    return hashlib.sha256(raw.encode("utf-8")).hexdigest()
第三段才是練習。create_session 用 func.random() 打亂符合類別與題型的題目,再依要求的題數截取。初次取得的 QuestionResponse 沒有正確答案欄位。提交答案後,submit_answer 才在伺服器比對答案、記錄結果並回傳正解。
弱項不是猜的,是按類別累積出來
這裡最需要確認的是「跨練習弱項」到底算了什麼。
get_weakness 先用 anonymous_id 找出練習紀錄,再把所有作答依題目類別分組。各類別的正確率是答對筆數除以總作答筆數,結果按正確率由低到高排列。前端再篩出低於 80% 的類別,最多取五類組成「針對弱項練習」按鈕,判斷式位於 src/templates/weakness.html。
1
2
const weakCats = data.categories.filter(c => c.percentage < 80).slice(0, 5);
const weakIds = weakCats.map(c => c.category_id).join(',');
所以這個判定有明確分母、門檻與排序方式。它算的是各類別歷次作答的累積正確率,不是能力測驗模型,也不會替近期成績加權。同一題做過多次,每次作答都會進入統計。這些界線來自 SessionAnswer.id 的筆數彙整方式,不是 README 對功能的自我描述。
方便的代價是格式耦合與匿名識別
題庫解析器直接依賴官方文件的版面文字與答案格式。只要段落標題不再是「是非題」或「選擇題」,或選擇題不再使用 1 到 4,現有規則就無法照原方式辨識。這項維護成本可從 _split_sections 與兩個題型解析函式直接看出來。
執行環境也不是單一靜態網頁。docker-compose.yml 會啟動應用程式與 PostgreSQL 16,並用 pgdata volume 保存資料。如果練習紀錄需要在磁碟故障後復原,部署時還要另外安排備份。
目前的跨練習識別使用瀏覽器 localStorage 裡的 gpa_anonymous_id,前端把它放進 /api/weakness 查詢參數。這段流程寫在 src/templates/weakness.html。對應路由只接收 anonymous_id,沒有帳號驗證依賴。這對家用工具很省事,但它不是存放正式測驗成績的權限設計。
適合家用練習,不適合直接當正式考試系統
如果題庫來源固定、使用者範圍明確,需求是打亂題序並找出常錯類別,這個專案已經把必要流程接起來。題庫有變動時,upsert_questions 也能更新、保留或軟刪除既有題目,不必每次清空資料庫。
如果要公開提供多人使用,還需要先處理帳號、授權、資料隔離與備份策略。若題庫版面經常改動,也要替解析器準備失敗報告與新格式測試。現有程式適合自用練習工具,不能直接視為正式考試平台。
先跑測試,再接自己的題庫
先確認依賴、CLI 入口與核心行為,再處理官方題庫檔案。以下命令已在 macOS、Python 3.14.2、uv 0.9.17 上實際執行。
1
2
3
4
5
git clone https://github.com/7a6ac0/gpa-question-webapp.git
cd gpa-question-webapp
uv sync --extra dev
uv run python -m src.ingestion.cli --help
uv run pytest -q
實測結果為 34 passed in 1.05s,CLI 也列出了 parse 子命令。這只確認目前 commit 的安裝與測試可以完成,不代表任何版本的官方 PDF 都能成功解析。下一步可從公共工程委員會題庫頁面下載一個類別的檔案,放進 data/,再依專案 README 的匯入指令處理。
真正有用的是留下可回頭查的練習紀錄
上面的可查證內容只能確認功能確實存在,而我仍判斷這個專案的價值在於完成一個複習循環,文中證據無法證明它會提高考試成績。
固定 PDF 能提供題目和答案,網站則把每次答題留成資料。隨機組卷切斷題序提示,類別統計指出下一輪該練哪裡。對這個家庭需求而言,技術選型只是手段,能持續完成「作答、發現弱項、再練一次」才是成品。
把第一份題庫跑通
開頭的問題是:怎麼把固定題庫改造成每輪順序不同、還能留下弱項的練習?
這個專案的答案很具體。解析器把 PDF 變成可查詢的題目,session 每次重新抽題,作答紀錄再按類別累積。它處理的是固定題序造成的熟悉感,適用範圍是自用或小範圍練習,不包含正式測驗需要的權限與管理機制。
最小的下一步是 clone 專案並跑完測試。確認本機環境正常後,再拿一份官方題庫驗證解析結果。
延伸閱讀
- gpa-question-webapp 原始碼:可直接對照本文提到的匯入、作答與弱項統計實作。
- 公共工程委員會採購專業人員題庫:取得這個專案實際處理的官方題庫來源。
- FastAPI 官方文件:理解路由、回應模型與相依注入的用法。
- SQLAlchemy 2.0 文件:查閱 session、查詢與 ORM 關聯的正式說明。